16 min di lettura
Questo articolo è una traduzione assistita dall’AI dell’originale in inglese, revisionata dall’autore.
Quando l’agente ha iniziato a scrivere oltre la campagna
Edizione di due settimane. Non c’è una edizione per la settimana 34, il salto era previsto, quindi tutto ciò che sta tra il quattordici e il ventisette di agosto è qui.
Due settimane fa scrivevo che la domanda per qualsiasi vendor con un server MCP aveva smesso di essere se ne avesse uno, ed era diventata quanti tool espone, quali di questi scrivono, quanto dura una sessione, di chi eredita i permessi e come si revoca.
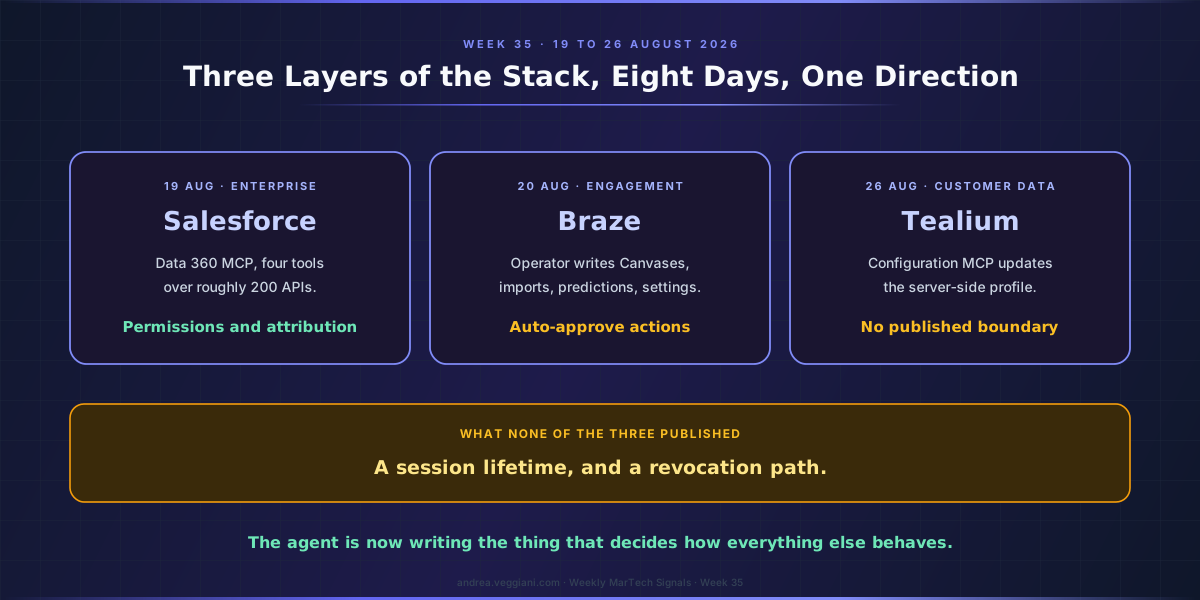
Tra il diciannove e il ventisette di agosto tre piattaforme della mia watchlist hanno dato a un agente accesso in scrittura a qualcosa per cui nessuna di quelle cinque domande era davvero stata scritta. Non a una campagna, e non a un’audience, ma alla configurazione del sistema stesso.
TL;DR
- Tre piattaforme hanno dato a un agente accesso in scrittura alla configurazione in otto giorni. Salesforce Data 360 MCP il diciannove, Braze Operator il venti con un’impostazione che rimuove lo step di conferma, il Configuration MCP di Tealium il ventisei. Salesforce ottiene il punteggio migliore, con eredità dei permessi e attribuzione per utente messe per iscritto.
- Un errore di configurazione non emerge come emerge un errore di campagna.
- L’autorità olandese per la protezione dei dati ha messo 824.990.000 euro sull’assenza di un essere umano, sanzionando Uber per disattivazioni interamente automatizzate e, separatamente, per non aver detto agli autisti che le decisioni erano automatizzate.
- Optimove e OpenAI hanno pubblicato confini di scrittura reali, e tutti gli altri hanno pubblicato elenchi di capability.
Il perimetro di scrittura è passato dalla campagna alla configurazione
Prendeteli nell’ordine in cui sono arrivati. Il diciannove Salesforce ha reso disponibile il suo server Data 360 MCP, esponendo circa duecento API ad agenti che possono costruire modelli semantici, trasformare dati e creare segmenti di audience, e ha esteso Headless 360 in open beta su ogni cloud, da Marketing a MuleSoft. Il venti Braze ha reso Operator disponibile: crea e modifica Canvas a partire da una descrizione in linguaggio naturale, che è lavoro di campagna, ma naviga anche da solo verso qualsiasi pagina della dashboard gli serva e agisce su user import, prediction, admin e settings, che non lo è. Arriva con un’impostazione chiamata Auto-approve actions che rimuove lo step di conferma prima di ognuna di quelle mosse. E il ventisei Tealium ha rilasciato un Configuration MCP la cui release note dice, senza mezzi termini, che permette ad agenti AI di leggere e aggiornare la vostra configurazione di profilo server-side in linguaggio naturale, per esplorare la configurazione, apportare modifiche e implementare nuovi casi d’uso senza navigare l’interfaccia.
Tre livelli dello stack, una sola direzione di marcia. Piattaforma di engagement, customer data platform e piattaforma enterprise hanno deciso ognuna nell’arco di otto giorni che la cosa più naturale da far scrivere a un agente è la cosa che decide come si comporta tutto il resto.
Nessuna delle tre ha pubblicato una durata di sessione o un percorso di revoca. Salesforce ci va più vicino e il merito va riconosciuto: la sua documentazione afferma che permessi sugli oggetti, field-level security, sharing rule e permission set si applicano tutti, che ogni transazione gira come l’utente autenticato attraverso una External Client App che porta lo scope mcp_api, e che l’audit trail attribuisce ogni azione a quell’utente. I trenta giorni di MoEngage, o sette giorni di inattività, pubblicati a luglio, restano l’unico numero sulla durata delle sessioni che un vendor di questa watchlist abbia messo per iscritto.
Una lezione sulla metrica che stavo usando. La risposta di Klaviyo alla domanda su quanti tool è più di duecentosessanta; la risposta di Salesforce è quattro, che smistano su oltre duecento API e su una libreria di skill che l’agente scopre a runtime. Stesso raggio d’azione, un ordine di grandezza di distanza sul numero. Ciò che governa è quello che il tool di dispatch riesce a raggiungere, che è esattamente il numero che nessuno pubblica. La proxy più vicina è comparsa nel change log ora leggibile di Salesforce, che ha registrato oltre cento oggetti aggiuntivi diventati raggiungibili in Setup in una sola settimana.
Una campagna sbagliata si vede. Una configurazione sbagliata no.
Questo spostamento conta per via di un’asimmetria nel modo in cui i due errori emergono.
Un Canvas costruito male da un agente viene intercettato nel giro di una settimana, perché qualcuno lo rivede prima del lancio, o perché i numeri sembrano sbagliati, e il difetto sta in un oggetto che un marketer può aprire e leggere. Una configurazione di profilo server-side modificata in modo leggermente sbagliato è un animale diverso, perché ogni campagna a valle si comporta poi esattamente come configurata, cioè correttamente, contro una definizione silenziosamente errata. L’attribuzione va alla deriva, un tratto si calcola sulla finestra sbagliata, un enrichment scatta su un trigger appena diverso da quello che qualcuno intendeva. Niente si rompe, niente segnala, e l’errore è invisibile dalla campagna perché la campagna non è dove quell’errore vive. Questa è l’architettura che non si vede su cui continuo a tornare, e un agente con un’interfaccia in linguaggio naturale verso di essa è un modo davvero nuovo di cambiarla senza che nessuno si accorga che è cambiata.
L’altro rilascio di Tealium nelle stesse quarantotto ore rende il punto più netto. Le AI enrichment applicano elaborazione basata su LLM a eventi in tempo reale, configurate con un prompt, un trigger e attributi di input e output con un nome, e l’output generato diventa un nuovo evento disponibile ad audience, connector e attivazione a valle. Questo mette un’inferenza di modello dentro il percorso degli eventi in tempo reale e ne porta l’output nella segmentazione, quindi latenza, determinismo, costo per evento e auditabilità smettono di essere proprietà della campagna e diventano proprietà dello stream di eventi, che è un altro team, un altro runbook e di solito un altro budget.
Matthew Niederberger ha posto la domanda adiacente a Martech Therapy: quando due sistemi non sono d’accordo su un cliente, su qualcosa di semplice come lo stato di opt-in email, quale valore vince?, e quella regola è scritta da qualche parte. Nei sistemi pacchettizzati decide il vendor, nei sistemi composable decide il vostro data team, e la maggior parte delle organizzazioni non ha mai fatto quella scelta in modo esplicito. Se un agente può aggiornare la configurazione di profilo in una piattaforma mentre un altro crea un segmento in una seconda, la regola di precedenza non è soltanto non scritta, viene cambiata a runtime da software che nessuno ha guardato.
Dove qualcuno il confine lo ha scritto
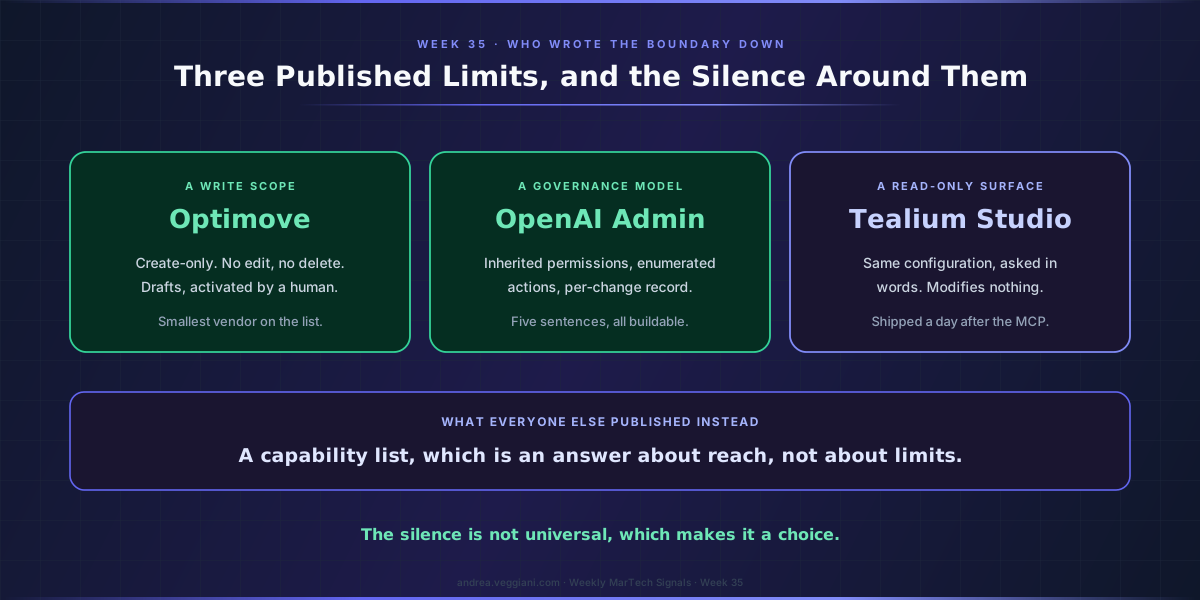
Il silenzio non è universale, e questo lo rende una scelta.
Tealium ha tracciato la linea dentro il proprio prodotto. Un giorno dopo il Configuration MCP ha rilasciato Studio, un’interfaccia di chat AI per porre domande in linguaggio naturale sulla stessa configurazione di profilo server-side, descritta nella release note come capace di dare risposte consapevoli dei permessi senza modificare o pubblicare alcunché. Due superfici agentiche sullo stesso sistema, a ventiquattro ore di distanza, una delle due esplicitamente in sola lettura. La stessa organizzazione di ingegneria ha mostrato nell’arco di una settimana che le superfici di lettura e di scrittura sono separabili quando qualcuno decide che debbano esserlo.
Optimove è andata oltre, in una nota sotto a un bullet di funzionalità che è facile scorrere senza leggere.
Le mission vengono create come bozze, quindi le attivate manualmente dopo revisione. Optimove MCP non può modificare o cancellare entità Optimove Gamify esistenti.
Solo creazione, nessuna modifica, nessuna cancellazione, e uno step di attivazione umana tra l’output dell’agente e qualsiasi cosa raggiunga un cliente. È il confine di scrittura pubblicato più preciso di questa watchlist, dal vendor più piccolo che ne fa parte, espresso come vincolo anziché come elenco di capability. Optimove afferma inoltre che le nuove funzionalità Gamify arrivano con capacità MCP salvo diversa indicazione, un default ingegneristico ragionevole che un buyer dovrebbe conoscere.
E in un mercato del tutto diverso, OpenAI ha pubblicato il modello di governance esattamente per la stessa mossa architetturale. Il suo Admin plugin permette a un agente di gestire i membri, controllare l’accesso a funzionalità e modelli per ruolo e regolare limiti d’uso e approvazioni di spesa, e l’annuncio afferma che opera dentro i permessi esistenti di ciascun utente senza concederne di più ampi, che ogni istruzione mappa su un’azione di lettura o scrittura supportata che restituisce un risultato strutturato, che i requisiti di approvazione vengono rispettati, che ogni modifica registra cosa è stato richiesto, se è stato completato e cosa è cambiato, e che le azioni a impatto più ampio possono essere riviste prima di essere applicate. Ne ho scritto più diffusamente nell’edizione AI, ma quelle cinque frasi stanno bene anche qui, e nessuna di esse è difficile da costruire. Questo è un divario di disclosure più che un divario di capability, e i divari di disclosure si chiudono quando i buyer chiedono numeri invece di accettare aggettivi.
Ottocentoventicinque milioni di euro per l’essere umano mancante
Il ventuno di agosto l’autorità olandese per la protezione dei dati ha sanzionato Uber per 824.990.000 euro per aver preso decisioni interamente automatizzate sugli autisti. Il software tracciava il comportamento di guida e le valutazioni dei clienti, e dove rilevava una sospetta frode, o dove le valutazioni scendevano troppo, gli account venivano disattivati automaticamente, con il reddito dell’autista attraverso la piattaforma che si fermava per tutta la durata e nessuna valutazione umana in alcun momento. La condotta è andata dal 2018 al 2022 ed è terminata.
L’autorità ha riscontrato due violazioni anziché una: il divieto di decisioni interamente automatizzate e, separatamente, la mancata informazione adeguata agli autisti sul fatto che le decisioni venivano prese in modo automatizzato. Quel secondo profilo è quello che con più probabilità raggiungerà per primo un’organizzazione di marketing, perché la trasparenza sul decisioning automatizzato è un problema di documentazione più che di architettura, e di solito non è il lavoro di nessuno.
Questo non è un caso di marketing, e non lo riporterei come tale se non fosse per quello che prezza e per quando lo fa. Nella stessa quindicina in cui tre piattaforme hanno rilasciato agenti che decidono e agiscono dentro sistemi di marketing, e una di loro ha aggiunto un’impostazione per rimuovere lo step di approvazione, un regolatore ha emesso la sanzione più alta che io abbia visto per l’assenza di un essere umano in una decisione automatizzata con conseguenze. L’esposizione dipende dal fatto che una decisione sia stata unicamente automatizzata e che abbia prodotto effetti giuridici o similmente significativi su una persona.
Gran parte del decisioning di campagna, soppressione da un canale inclusa, non supera quella soglia, ed è giusto restare calmi su questo. Le decisioni di eleggibilità, il pricing individualizzato, il ritiro di un’offerta su cui un cliente conta e qualsiasi cosa tocchi lo stato di un account sempre di più potrebbero superarla, e quasi tutti i vendor qui rilasciano ormai un agente che può raggiungerne almeno una. Un elemento più sommesso dello stesso regolatore rende l’incentivo più netto: dal primo di settembre dovrà pubblicare le proprie sanzioni per legge e non più per policy, e un registro sanzionatorio completo è un argomento migliore di uno discrezionale.
Pega è l’unica ad aver rilasciato nella direzione opposta nella stessa finestra, con explainability configurabile in T-Switch, un Customer Profile Viewer e un Ethical Bias Check che gira prima del deployment anziché dopo un audit, l’unico rilascio di questa quindicina che tratta l’explainability come una funzionalità da spedire e non come un questionario di due diligence.
Il click di approvazione smette di essere un controllo nel momento in cui diventa routine
Il diciassette Anthropic ha rimosso l’opzione per consentire tutte le azioni del browser dalle sue permission card, lasciando l’approvazione per singolo sito come concessione più grossolana disponibile, e il giorno dopo ha aggiunto un breve ritardo ai prompt di permesso per il computer use, perché un tasto di invio diretto alla casella del messaggio poteva prima finire sul prompt e approvarlo. Due giorni dopo, Braze ha rilasciato un’impostazione il cui scopo è smettere di chiedere.
Ho scritto del lato di design di quel contrasto nell’edizione AI. Quello che mi preoccupa qui discende dalla decisione olandese di cui sopra, che verteva sul fatto che ci fosse un essere umano nel loop e sul fatto che qualcuno potesse dimostrarlo dopo.
Un prompt di approvazione produce un log, e un log sembra evidenza. Ma un prompt che scatta quaranta volte all’ora produce un log di approvazioni concesse in meno di un secondo da qualcuno che non può in alcun modo averle lette, e questa è evidenza di abitudine più che di coinvolgimento umano in qualsiasi senso un regolatore riconoscerebbe. Se la vostra organizzazione dovrà mai dimostrare che una persona è stata coinvolta in modo significativo in una decisione automatizzata con conseguenze, l’artefatto che vi serve è un piccolo numero di approvazioni che hanno richiesto tempo, su decisioni per cui valeva la pena fermarsi.
Il che rende un interruttore di auto-approvazione una decisione di governance e non un’impostazione di comodo, e come tale andrebbe registrata, con un nome e una ragione.
Le quiet hours sono diventate un oggetto di policy
Questo è un elemento più piccolo con una conseguenza più grande.
Adobe ha aggiunto le Quiet Hours alle Orchestrated Campaigns come esclusioni temporali definite per ragioni di preferenza e compliance, e due giorni dopo Braze ha rilasciato le quiet hours di workspace in early access, impostando una finestra di default per canale di messaggistica su un intero workspace, rispettata nel fuso orario locale di ciascun destinatario da ogni campagna su quel canale, con un opt-out per singola campagna. Iterable ci era arrivata prima, rilasciando quiet hours di default per le nuove campagne SMS a giugno, quindi ciò che è cambiato in questa quindicina è l’ambito e non l’idea.
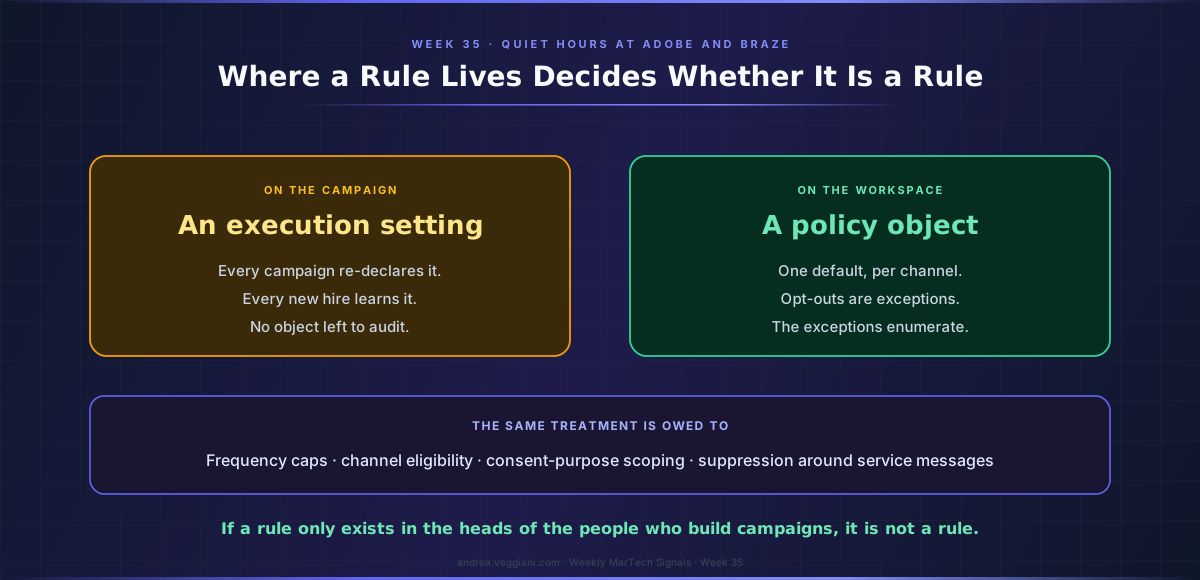
La differenza architetturale tra le due forme è più grande di quanto sembri. Una regola di quiet hours che vive sulla campagna è un’impostazione di esecuzione: ogni nuova campagna deve ridichiararla, ogni nuovo assunto deve impararla e nessun audit può farla rispettare, perché non c’è un oggetto da controllare. Una regola di quiet hours che vive sul workspace con un opt-out esplicito è un oggetto di policy: ha un default, ha eccezioni, e le eccezioni sono enumerabili. Le restrizioni di New York sulle notifiche push notturne ai minori di diciotto anni, di cui ho scritto quando sono arrivate, sono esattamente il tipo di obbligo che non si può soddisfare chiedendo a ogni owner di campagna di ricordarsi qualcosa.
Qualsiasi cosa facciate rispettare per convenzione tra le campagne è candidata allo stesso trattamento, e la lista è più lunga di quanto la maggior parte dei team si aspetti una volta messa per iscritto: frequency cap, eleggibilità di canale, scoping delle finalità di consenso, finestre di soppressione attorno ai messaggi di servizio. Se l’unico posto in cui una regola esiste è la testa delle persone che costruiscono le campagne, non è una regola.
L’agente che legge un journey invece di scriverlo
Alla maggior parte degli agenti presi in rassegna in questa edizione è stato dato qualcosa da costruire. Iterable, il diciotto, ha dato al suo agente qualcosa da leggere, e penso che sia il prodotto più utile.
Journey Summary mantiene una descrizione permanente di ogni journey salvato o pubblicato, costruita a partire dai suoi tile, dalle regole di ingresso e uscita, dai webhook, dai live data e dalle label, così che Nova Agent possa rispondere a tre domande su di esso: cosa fa questo journey, chi va dove e perché e, quella interessante, a cosa dovreste fare attenzione, con Iterable che cita come esempi criteri di ingresso troppo ampi e regole di uscita mancanti.
Chiunque abbia ereditato un’istanza matura di Braze, Iterable o Journey Optimizer sa che costruire i journey non è mai stata la parte difficile. La parte difficile è che nessuno sa dirvi cosa fanno i trecento journey attivi, quali due competono per la stessa audience nella stessa mattina, o quale non ha criteri di uscita e sta silenziosamente rimandando messaggi alla stessa coorte da quando il campaign manager che lo ha costruito se n’è andato. È per questo che gli audit di uno stack esistente richiedono il tempo che richiedono.
Un agente che scrive journey rende quel problema più grande, e più in fretta. Un agente che li legge, li spiega e ne segnala i difetti di progettazione è il primo strumento che qualcuno abbia rilasciato che lo rende più piccolo. Solo uno dei due può girare senza sorveglianza senza prima una conversazione di governance, e se state scegliendo dove puntare un agente in uno stack che non avete costruito voi, puntatelo sull’audit e non sull’authoring.
Cosa chiedere lunedì
Tre domande e due date, e poi una cosa arrivata del tutto da fuori watchlist.
Chiedete a ogni vendor il cui agente può scrivere di rispondere alle cinque frasi pubblicate da OpenAI qui sopra: permessi ereditati e nulla di più ampio, ogni istruzione mappata su un’azione di lettura o scrittura enumerata, requisiti di approvazione rispettati, un registro per singola modifica e revisione prima che si applichino le azioni ad alto impatto. Se la risposta è un elenco di capability, avete imparato qualcosa. Chiedete a chi possiede il decisioning un inventario scritto dei tipi di decisione, annotando per ciascuno se c’è un essere umano nel loop, quale evidenza lo registra e se la persona viene informata che la decisione era automatizzata. E chiedetevi se i vostri prompt di approvazione sono abbastanza rari da voler dire qualcosa.
Le due date sono vicine. Marketo rimuove il parametro di query access_token il trentuno di agosto, quindi qualsiasi integrazione REST che si autentica ancora via query string smette di funzionare questa settimana. E Gmail sta distribuendo avvisi sui link non HTTPS entro fine ottobre, che Twilio ha indicato come motivo per cui ha rilasciato il provisioning SSL automatico sul link branding di SendGrid. Riguarda ogni tracking domain brandizzato presso ogni ESP, e sta insieme a tutto ciò che inizia prima dell’invio.
L’elemento esterno non era in nessuna release note di vendor che io monitori. ChatGPT Ads si è esteso a trentuno paesi europei Italia inclusa in questa quindicina, e l’ingresso nel mercato non è la parte che conta. La piattaforma ora fa bidding ottimizzato per conversione, supporta custom audience e riporta attraverso un OpenAI Pixel, una Conversions API e integrazioni di misurazione di terze parti, che è l’interfaccia standard tra una piattaforma pubblicitaria e uno stack di marketing più che il corredo di un esperimento pubblicitario, e mette OpenAI dentro ogni conversazione su tagging server-side e ambito del consenso. Le domande che ne seguono non sono domande di media: quel pixel passa attraverso il vostro tag manager e il vostro consent framework o gli gira intorno, e quale finalità di consenso lo copre.
Il record di questa edizione è in MarTech Watch, Settimana 35.
L’agente ha smesso di scrivere campagne e ha iniziato a scrivere le configurazioni della macchina che le fa girare, e il resoconto più chiaro di ciò che non può toccare è arrivato dal vendor più piccolo della lista, in una nota sotto a un bullet di funzionalità.
Fonti
Superfici di scrittura degli agenti
- Tealium release notes, 2026. Configuration MCP e AI enrichment (26 agosto), Tealium Studio (27 agosto). Date confermate sull’Atom feed.
- Braze, release del 20 agosto 2026. Disponibilità generale di Operator, navigazione della dashboard, Auto-approve actions, quiet hours di workspace.
- Salesforce, expanding Headless 360. Disponibilità generale di Data 360 MCP, open beta di Headless 360, Agent Skills.
- Documentazione Salesforce Headless 360 MCP. Il contratto a quattro tool e il modello di permessi pubblicato.
- Salesforce Release Note Changes. Il log settimanale che registra oltre cento oggetti aggiuntivi in Setup.
- Optimove What’s New, agosto 2026. Optimove Gamify in Optimove MCP, e il confine di scrittura pubblicato.
- OpenAI, Introducing the Admin plugin. Le cinque garanzie di governance pubblicate.
Regolamentazione
- Autoriteit Persoonsgegevens, sanzione a Uber, 21 agosto. L’importo, le due violazioni e il periodo dal 2018 al 2022.
- Autoriteit Persoonsgegevens, pubblicazione obbligatoria delle sanzioni, 27 agosto. In vigore dal 1 settembre 2026.
- Nota della CNIL sulla sanzione Uber, 24 agosto. La pubblicazione dell’autorità che ha cooperato.
- Pega, capacità di AI responsabile e partnership con Gryphon, 18 agosto. T-Switch, Customer Profile Viewer, Ethical Bias Check.
Orchestrazione e contenuti
- Adobe Journey Optimizer release notes. Quiet Hours e send using waves (18 agosto), limiti al numero di frammenti che bloccano la pubblicazione (25 agosto).
- Iterable 2026 release notes. Journey Summary (18 agosto), e quiet hours di default per le nuove campagne SMS (giugno).
- Anthropic Claude Desktop changelog. Rimozione dell’opzione di consenso a tutte le azioni del browser (17 agosto) e irrigidimento del prompt di computer use (18 agosto).
Scadenze e livello media
- Adobe Marketo Engage release notes. La rimozione di
access_tokenil 31 agosto 2026. - Twilio changelog. Provisioning SSL automatico per SendGrid, e gli avvisi di Gmail sui link non HTTPS da fine ottobre 2026.
- OpenAI, ChatGPT Ads expands across Europe. Trentuno mercati, oCPC, custom audience, OpenAI Pixel e Conversions API.
Analisi citate, non usate come fonte di fatti
- Martech Therapy, su quale contesto vince quando due sistemi non concordano. Matthew Niederberger, 24 agosto 2026.
Il digest alla base di ogni articolo settimanale è prodotto attraverso una scansione strutturata, assistita dall’AI, di release note ufficiali e fonti di product update. Io rivedo l’output, verifico i segnali rilevanti e scrivo l’interpretazione architetturale.
Questo articolo si basa sulle scansioni del Martech Weekly Digest eseguite il 27 agosto 2026, che coprivano le due settimane dal 14 al 27 agosto su diverse piattaforme CEP e vendor. Il record datato che ne sta alla base è in MarTech Watch, Settimana 35.
Se trovate errori o lacune nella copertura, voglio saperlo. Il processo migliora quando l’output viene messo in discussione.


