Questo articolo è una traduzione assistita dall’AI dell’originale in inglese, revisionata dall’autore.
TL;DR: MarTech Ledger è un registro pubblico, datato e con fonti di cosa rilasciano, annunciano e ritirano 15 piattaforme di marketing, a partire dal 1° gennaio 2026. Una pipeline costruita attorno a Claude legge le release note dei vendor con una cadenza dichiarata, scrive ogni cambiamento in un formato fisso e lo pubblica solo dopo una serie di controlli deterministici. Serve ad architetti, partner di implementazione, analisti e team di product marketing che devono sapere cosa una piattaforma ha davvero rilasciato e quando, e lascia ogni opinione a questo sito.
La domanda a cui rispondevo a mano
Ogni giovedì sera, quando si chiude la MarTech Watch, finisco per rispondere alla stessa domanda per almeno una piattaforma: questa funzionalità è disponibile per tutti, e da quando? Sembra un dettaglio, finché non si guarda quanto ci dipende. Ci dipende una platform selection, perché una capability ancora in preview limitata è una voce di roadmap e va prezzata come tale. Ci dipende un piano di migrazione, perché il giorno del cutover la piattaforma di destinazione deve fare quello che la piattaforma di origine fa oggi. E ci dipende la slide di roadmap di un cliente, più spesso di quanto si ammetta.
I vendor la risposta la pubblicano, ma a pezzi. Una funzionalità compare come annuncio su un palco, poi come beta in una release note, poi come early access con un’etichetta diversa, infine come riga GA in un changelog che può citare o meno la regione o il data center a cui si applica. Tornare su una funzionalità dopo qualche mese significa ricostruirne la storia da quei pezzi: era stata solo annunciata? Era in beta? La disponibilità generale valeva per tutte le regioni? E la data sulla pagina era quella del rilascio o quella in cui una pagina ne confermava l’esistenza? La Watch intercetta ogni pezzo nella settimana in cui esce e le mie movement notes sulle CEP li ricompongono per un trimestre, ma sono entrambe prosa, e la prosa non si interroga su quindici piattaforme e dieci mesi.
MarTech Ledger trasforma quella domanda ricorrente in un registro, in cui ogni cambiamento è datato, classificato e collegato alle parole del vendor, così che la risposta si possa cercare invece di ricostruirla.
Cosa registra MarTech Ledger tra CEP, CDP e marketing automation B2B
Il registro copre 15 piattaforme di 11 vendor, raggruppate in tre categorie che seguono il modo in cui già scrivo del mercato:
- CEP: Adobe Journey Optimizer, Bloomreach Engagement, Braze, Iterable, Klaviyo, MoEngage, Salesforce Marketing Cloud Engagement e Salesforce Marketing Cloud Next.
- CDP: Adobe Experience Platform, Hightouch, Tealium e Treasure AI.
- MAP B2B: HubSpot Marketing Hub, Adobe Marketo Engage e Salesforce Account Engagement.
A fine ottobre il Ledger contiene quasi 2.200 record di funzionalità letti da 19 fonti monitorate dei vendor e 9 archivi storici, più 65 segnali di mercato (acquisizioni, partnership, cambi di packaging e rebrand) che stanno sulla timeline senza mai contare come funzionalità. La storia parte lo stesso giorno per tutte le piattaforme, il 1° gennaio 2026, così due timeline affiancate cominciano dalla stessa linea.
Ogni record ha gli stessi campi, chiunque sia il vendor: uno stato del ciclo di vita preso da una lista chiusa di sette (announced, preview, beta, GA, GA regionale, deprecation announced e retired), la data dichiarata dal vendor con la sua precisione reale, per cui una data nota solo al mese resta un mese e non riceve mai un giorno inventato, le regioni a cui si applica, un livello di significatività (major, notable o minor) e una capability presa da una tassonomia pubblica di 81 capability in 16 aree, oggi alla versione 1.6 e con lo storico delle versioni anch’esso pubblico.
Tenere distinti questi passaggi è il senso del registro. Un annuncio non dimostra che una funzionalità sia utilizzabile, una beta è ancora lontana dalla disponibilità generale e una data di fine servizio già trascorsa non basta da sola a confermare il ritiro, per cui il Ledger registra un ritiro solo quando una fonte lo dice. Se una fonte conferma che una funzionalità era disponibile entro una certa data, senza dire quando lo è diventata, il record usa l’indicazione “Confirmed by”, che non vale mai come data di rilascio né come ritardo.
Con questi campi il registro risponde a quattro domande a cui una release note da sola non risponde. Parity: quali piattaforme hanno una capability in GA, e da quando? Sequence: chi l’ha rilasciata per primo su un tema, e chi è venuto dopo? Cadence: dove sta investendo ogni vendor, area per area, nel tempo? Lifecycle: cosa viene deprecato o ritirato? È il segnale che quasi nessuno segue, ed è quello che conta di più per i team che hanno costruito sulla funzionalità che sparisce.
Un registro datato dei rilasci, senza punteggi
I siti di recensioni e le pagine di confronto dei vendor mostrano un prodotto in un momento preciso, di solito quello in cui qualcuno ha scelto di descriverlo sotto la luce migliore. Il Ledger è costruito sull’asse opposto, il tempo. Una fotografia dice dove si trova un prodotto, una traiettoria mostra anche come ci è arrivato e quanto mantiene le promesse, e il registro le promesse le traccia: quando un vendor annuncia una funzionalità con una data prevista, la scheda la mostra e poi indica se è arrivata in tempo o con quanti giorni di ritardo, misurati solo rispetto allo stato che il vendor aveva effettivamente indicato.
Quello che il Ledger si rifiuta di fare conta quanto quello che registra. Non pubblica punteggi, classifiche, etichette “best for” o raccomandazioni, perché il numero di record per piattaforma misura soprattutto quanto finemente un vendor documenta il proprio lavoro, e un vendor che scrive una riga di changelog per ogni connettore vincerebbe qualunque classifica costruita sui conteggi. Per la stessa ragione la Release Matrix mostra solo lo stato più avanzato registrato per ogni capability, tiene i conteggi fuori dalle celle, esclude di default gli aggiornamenti minori e dichiara nell’intestazione che mostra rilasci registrati, e che non è un inventario di capability.
Nel registro si entra in tre modi: dagli aggiornamenti recenti in home page, seguendo una singola piattaforma nella sua timeline, oppure scegliendo una capability e guardando come si è mossa tra prodotti diversi. La Release Matrix ordina i cambiamenti registrati per piattaforma e capability, e le viste con due piattaforme affiancate scendono fino al singolo record e alla fonte di ogni stato.
L’assenza segue la stessa disciplina. Una cella vuota nel Ledger significa che lì non è stato registrato nessun rilascio, il che è un’affermazione diversa dal dire che la piattaforma non sa farlo. Molte capability esistevano già prima di gennaio 2026 e molti vendor documentano alcune aree meglio di altre, per cui il sito non afferma mai che a un prodotto manca qualcosa e spiega nella metodologia perché non può farlo. La GA è la vista di default ovunque, mentre annunci e beta restano visibili ma distinti, perché annunciare di più non deve mai sembrare rilasciare di più. Il giudizio su quale piattaforma si adatta a quale organizzazione resta dov’è sempre stato, in articoli come le mie Field Notes on CEP.
Come funziona la pipeline di MarTech Ledger
Il principio di progetto sta in una riga della specifica: deterministico dove possibile, un modello linguistico dove serve. Recupero, pulizia, merge e validazione sono script che si comportano sempre allo stesso modo, e il modello si usa solo nel passaggio che richiede di capire un testo, cioè trasformare il paragrafo di un vendor in un record strutturato.
La giornata comincia alle 04:17 UTC, quando il job di fetch legge ogni fonte attiva secondo la sua cadenza (quasi tutte ogni giorno), tiene solo i blocchi cambiati dall’ultima visita e salva il testo grezzo in privato. Mezz’ora dopo il job di estrazione prende ogni piattaforma con materiale nuovo, prepara una versione pulita del testo cambiato con i marcatori del linguaggio pre-rilascio e la passa a Claude, che gira dentro GitHub Actions e propone i record in un formato JSON fisso. Il modello sceglie le capability solo dalla tassonomia esistente; quando qualcosa non rientra, può proporre una nuova capability in una coda separata che rivedo io, ed è così che la tassonomia è passata da 70 a 81 capability nelle prime settimane senza che il modello ne inventasse mai una al volo.
Uno script di resolve collega poi ogni stato proposto alle fonti da cui viene, registra quando la pipeline lo ha visto per la prima volta accanto alla data dichiarata dal vendor e unisce il risultato al record esistente. Segue la validazione, su due livelli: un controllo JSON Schema su ogni file e una serie di regole che uno schema non sa esprimere, come stati e date che non tornano mai indietro, mai due stati della stessa funzionalità nello stesso giorno, ogni capability presente nella tassonomia corrente e ogni URL di fonte su un dominio ammesso. Ogni esecuzione arriva su un branch come pull request, che fa merge solo se la validazione passa e altrimenti aspetta me. Un passaggio di compile scrive infine la proiezione pubblica, da cui si ricostruisce il sito statico.
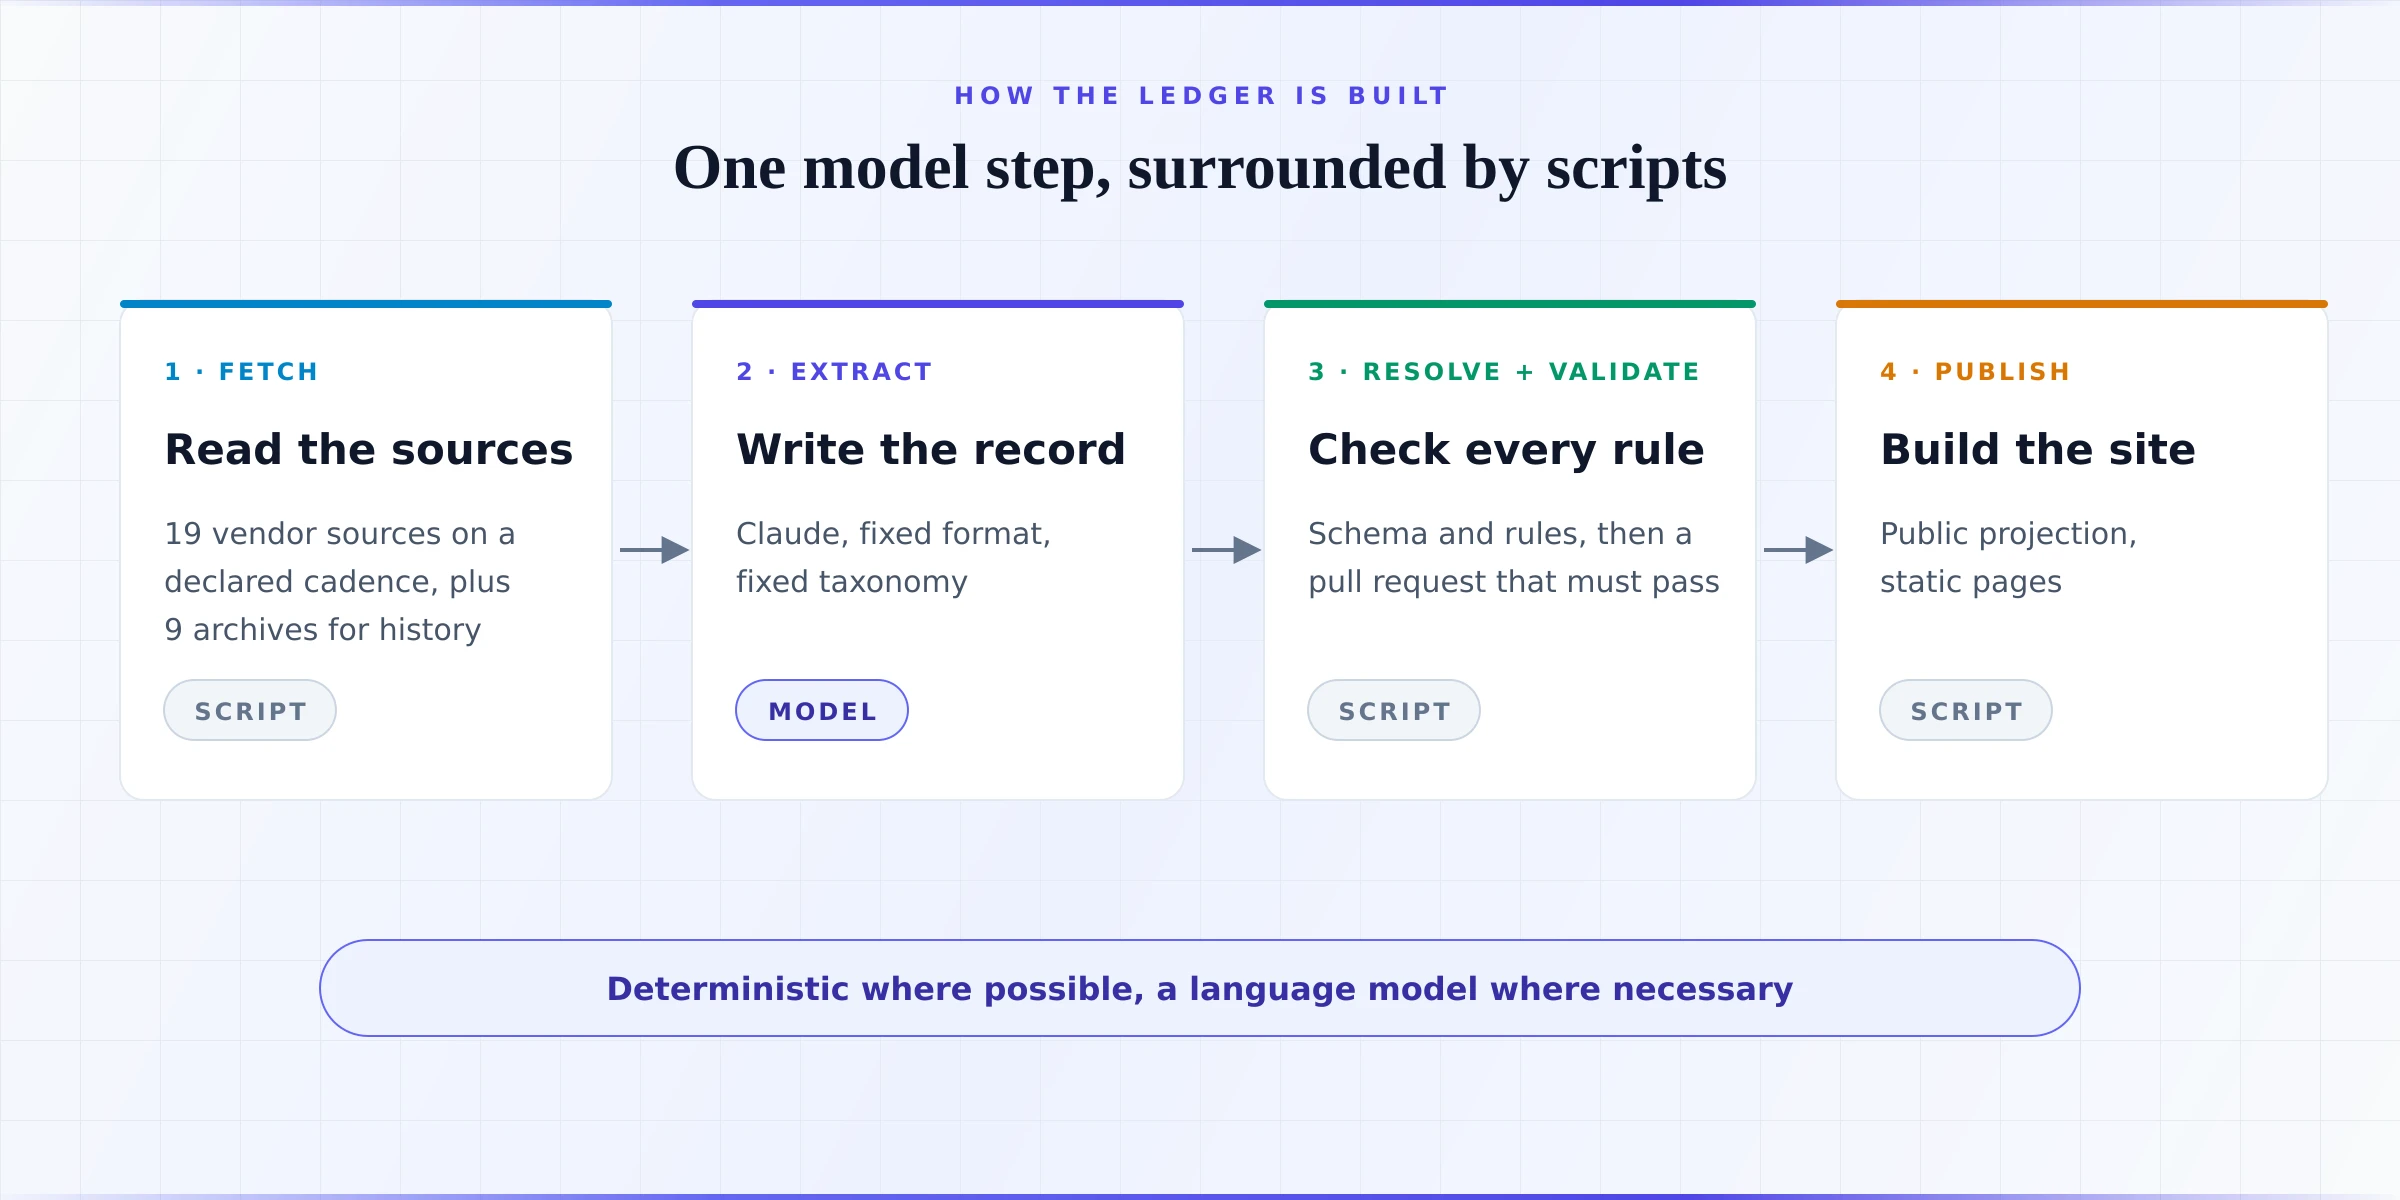
Figura 1. Il modello gestisce un passaggio su quattro; tutto il resto è uno script che si comporta ogni giorno allo stesso modo.
Non tutte le fonti collaborano. HubSpot Community sta dietro una verifica che blocca i runner in cloud, quindi la legge due volte a settimana un task schedulato che usa il browser integrato nell’app desktop di Claude, sul mio computer. Salesforce Help ha cominciato a servire una pagina di errore al browser headless del fetcher, e la soluzione è stata avviare Chromium completo.
Gli strumenti dietro MarTech Ledger
Lo stack è piccolo di proposito, e ogni pezzo è stato scelto perché una persona sola possa far girare tutto accanto a un lavoro a tempo pieno:
- Claude (Anthropic) fa l’estrazione, tramite la GitHub Action ufficiale e il mio abbonamento personale, e Claude Cowork è dove ho progettato la pipeline, dove ne rivedo l’output a lotti e da dove partono i task schedulati che hanno bisogno del mio computer.
- GitHub ospita un repository privato dei dati e uno privato del testo grezzo. Nei dati non si scrive nulla se non tramite pull request, per cui ogni modifica al registro è un diff revisionabile, con la sua storia.
- Script Python gestiscono fetch, preparazione, resolve, validazione e compile, con Playwright per le pagine che si vedono solo in un browser, e JSON Schema definisce ogni entità e il contratto che il modello deve rispettare.
- Astro costruisce il sito come pagine statiche, una per funzionalità, piattaforma, capability e mese della timeline, servite dagli static assets di Cloudflare Workers sul dominio martechledger.com.
- Codex, Gemini e ChatGPT fanno da revisori indipendenti del sito prima che le modifiche vadano online, in sola lettura, con rilievi numerati che accetto o respingo uno per uno.
Il Ledger condivide font e colori con questo sito, così i due si riconoscono come una famiglia pur con nomi e ruoli propri. Un’idea del modello dati è presa in prestito: salvare, accanto alla data dichiarata dal vendor, il momento in cui la pipeline ha visto il cambiamento viene da Releasebot, che separa la data letta dalla fonte dal “first seen”. Sul Ledger quel secondo timestamp rende misurabile il ritardo di registrazione, e quindi pubblicabile.
Le regole che tengono onesto il registro
Ogni fatto del Ledger ha almeno una fonte, e ogni fonte sta su un dominio del vendor che la pipeline è autorizzata a citare. Ogni stato indica anche dove è stato letto: release note, changelog, documentazione, post della community oppure un annuncio riportato dalla mia MarTech Watch, che è etichettato come tale e può produrre solo uno stato “announced”. Quell’etichetta descrive il tipo di fonte e non lo giudica; i punteggi di confidenza del modello restano privati, perché un numero pubblicato suggerirebbe una precisione che il processo non ha.
Quando emerge un dubbio, durante l’estrazione, da una regola di validazione o in una mia revisione (il caso tipico sono due fonti che non concordano sulla data dello stesso stato), il record va “under review”, resta visibile con il dubbio dichiarato ed esce dalla Release Matrix e dalle viste affiancate finché il dubbio non si risolve. Ogni modifica che faccio a un fatto pubblicato finisce in un registro delle correzioni pubblico, campo per campo, con valore prima e dopo, motivo ed evidenza; a fine ottobre conteneva 101 voci. Chi legge può segnalare un errore su qualsiasi record con un modulo già compilato con il suo identificativo, e la segnalazione fa partire una verifica sulle fonti pubbliche senza mai diventare da sola la base di una modifica.
La pipeline misura anche sé stessa, in pubblico. La pagina di stato mostra il recording lag per piattaforma, cioè i giorni tra la data dichiarata dal vendor e il momento in cui la pipeline l’ha vista, e dà una mediana solo con almeno cinque osservazioni. Prima del lancio ho misurato la recall rispetto alla mia Watch su venti settimane di storico: il 78% delle voci rilevanti della Watch aveva un record corrispondente nel Ledger, l’88% contando le corrispondenze parziali, e i mancati (soprattutto annunci usciti solo sulla stampa e aggiornamenti minori saltati) sono diventati due correzioni alle regole di estrazione e una corsia dedicata agli annunci. È la risposta pratica al problema descritto in come i sistemi agentici falliscono in silenzio: il registro può sbagliare, e almeno mostra dove potrebbe farlo.
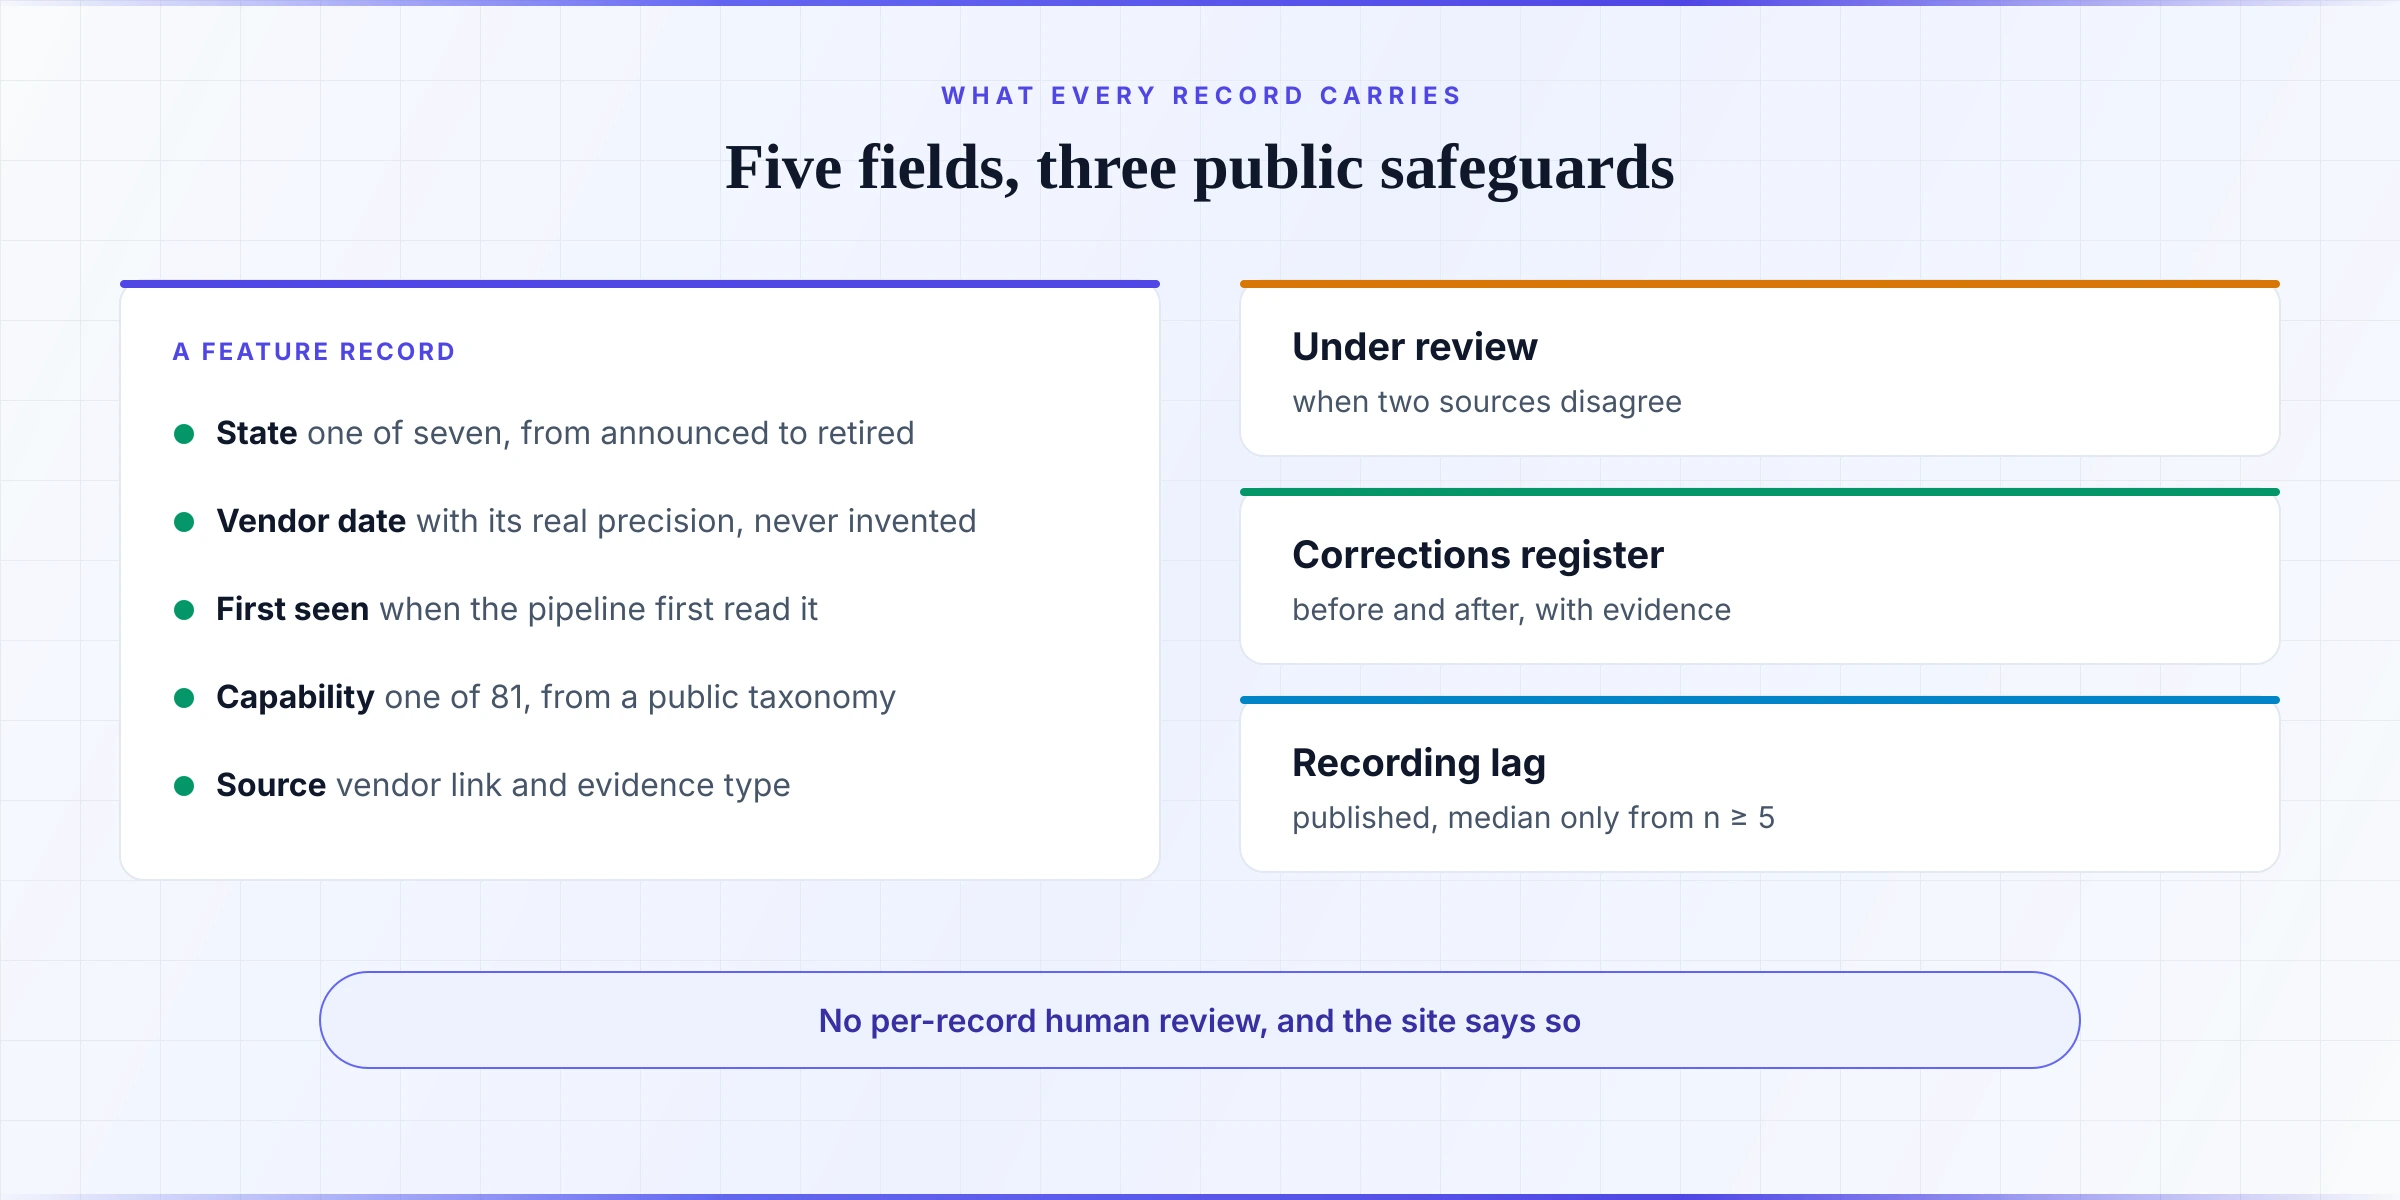
Figura 2. Le salvaguardie sono visibili sul record stesso, così chi legge può giudicare ogni voce senza fidarsi del processo a scatola chiusa.
Due dichiarazioni completano il quadro. I record sono scritti dall’AI e nessuno li rivede uno per uno, per cui ogni pagina che li mostra porta l’icona “AI generated” della Commissione europea ai sensi dell’articolo 50 dell’AI Act, con un link alla pagina che spiega come si usa l’AI e cosa non fa. La pagina About dichiara che sono un consulente certificato su diverse delle piattaforme tracciate e che le implemento per i clienti, un potenziale conflitto di interessi dichiarato come tale, che pipeline e regole sono le stesse per ogni vendor e che nessun vendor paga, rivede o influenza ciò che viene registrato.
A chi serve MarTech Ledger, e dove stanno le opinioni
Il registro è scritto per chi ha bisogno di fatti datati più che di un verdetto: architetti MarTech che verificano se una capability è disponibile nella regione giusta prima di progettarci sopra, partner di implementazione che preparano una migrazione, analisti che seguono dove si muove il mercato e team di product marketing e competitive intelligence che tengono traccia di cosa rilasciano davvero i concorrenti. In pratica può servire a preparare un incontro con un vendor, ritrovare la fonte di un rilascio citato in un workshop, seguire una deprecazione fino alla data di fine servizio od osservare come una capability evolve tra più piattaforme. Non è pensato come guida all’acquisto per i CMO, e non avrà punteggi riassuntivi o badge “best for”, che appartengono a un altro tipo di prodotto.
L’interpretazione sta qui. Il Ledger rimanda ad andrea.veggiani.com con parsimonia, al massimo una volta per pagina e solo dove un articolo tratta davvero l’argomento, sotto l’etichetta “The author’s view” con la data di pubblicazione, così chi legge sa sempre quando lascia il registro per un’opinione. La Watch continua in parallelo, e i Pattern mensili leggono già il mercato con la tassonomia del Ledger. Quando il 20 ottobre Salesforce ha firmato l’accordo per acquisire Braze, il Ledger ha registrato un segnale con entrambi i vendor e la sua fonte; cosa significhi l’operazione per uno stack l’ho scritto su questo sito, in cosa cambia per il vostro stack.
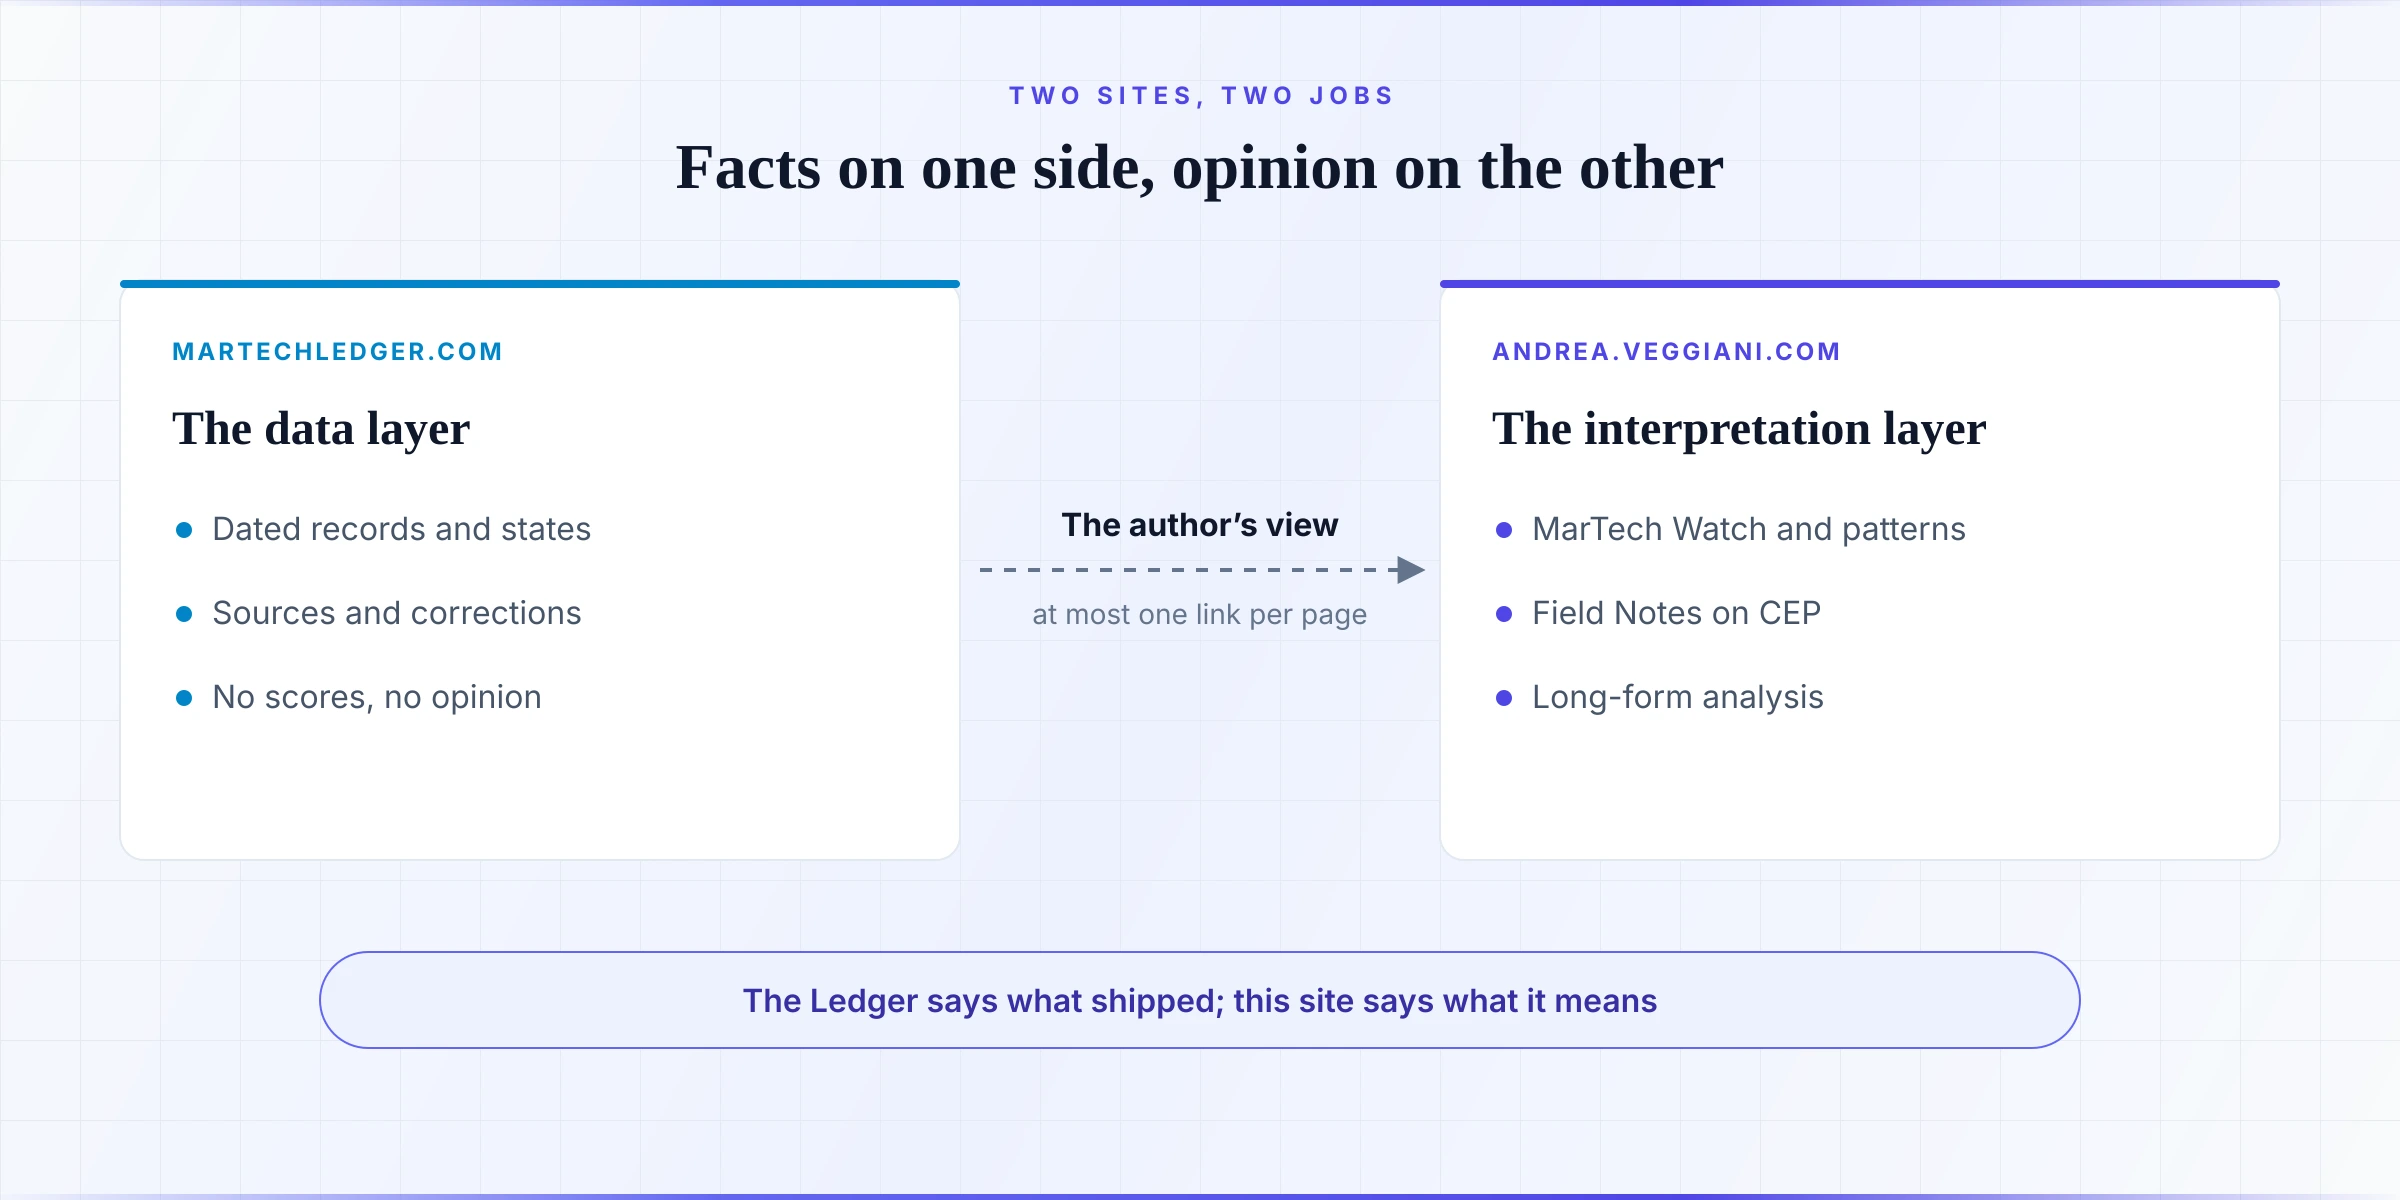
Figura 3. Tenere fatti e opinioni su siti separati rende entrambi più affidabili, e fa del link tra i due una scelta esplicita.
Cosa significa Beta, e cosa viene dopo
L’intestazione del Ledger porta un badge Beta, che ha un significato preciso: la copertura sta ancora crescendo, i metodi possono cambiare, le voci dubbie restano visibili e i link restano stabili. Finché c’è il badge i feed RSS sono spenti, e il download del dataset resta senza link finché non ne avrò deciso la licenza. Tre piattaforme (Insider One, Zeotap e GrowthLoop) sono rinviate perché le loro fonti pubbliche non sono ancora datate abbastanza bene per le regole del registro, e il modello dati è costruito in modo che una nuova categoria o un nuovo vendor siano una questione di configurazione, che è poi come la marketing automation B2B si è aggiunta a inizio ottobre al perimetro iniziale di CEP e CDP. Il registro rende espliciti il proprio perimetro, le fonti monitorate e i limiti del metodo, senza la pretesa di raccogliere ogni cambiamento del mercato.
Il modo migliore per metterlo alla prova è partire da una piattaforma che conosci: apri un record, segui il link alla fonte del vendor e, se non coincidono, usa “Report an issue” sul record, perché è anche da questo riscontro che il registro diventa più utile.
Il prossimo giovedì sera, quando la stessa domanda tornerà per una funzionalità che ricordo a metà, non cercherò la risposta in tre release note e un comunicato stampa. La risposta a “è in GA, e da quando?” dovrebbe essere un link che chiunque può verificare, e per quindici piattaforme adesso lo è.
Fonti
MarTech Ledger
- About MarTech Ledger. Perimetro, pubblico, significato di Beta e disclosure dell’autore.
- Methodology. Fonti, stati del ciclo di vita, regole di validazione e significato dell’assenza.
- How AI is used. Cosa fa il modello, cosa non fa, e l’etichetta AI generated.
- Corrections. Il registro pubblico delle modifiche ai fatti pubblicati.
- Taxonomy. Le 81 capability in 16 aree e lo storico delle versioni.
Strumenti e piattaforme
- Claude Code GitHub Actions. La GitHub Action che esegue il passaggio di estrazione.
- Cloudflare Workers static assets. Il modello di hosting del sito statico.
- Astro. Il framework del sito statico.
- JSON Schema. Lo standard di validazione per ogni entità e per il contratto di output del modello.
- Releasebot methodology. L’origine dell’idea di salvare il “first seen” accanto alla data letta dalla fonte.
Normativa
- The EU AI Act’s transparency rules: a practical guide to Article 50. Gli obblighi di etichettatura dietro l’icona AI generated.