Questo articolo è una traduzione assistita dall’AI dell’originale in inglese, revisionata dall’autore.
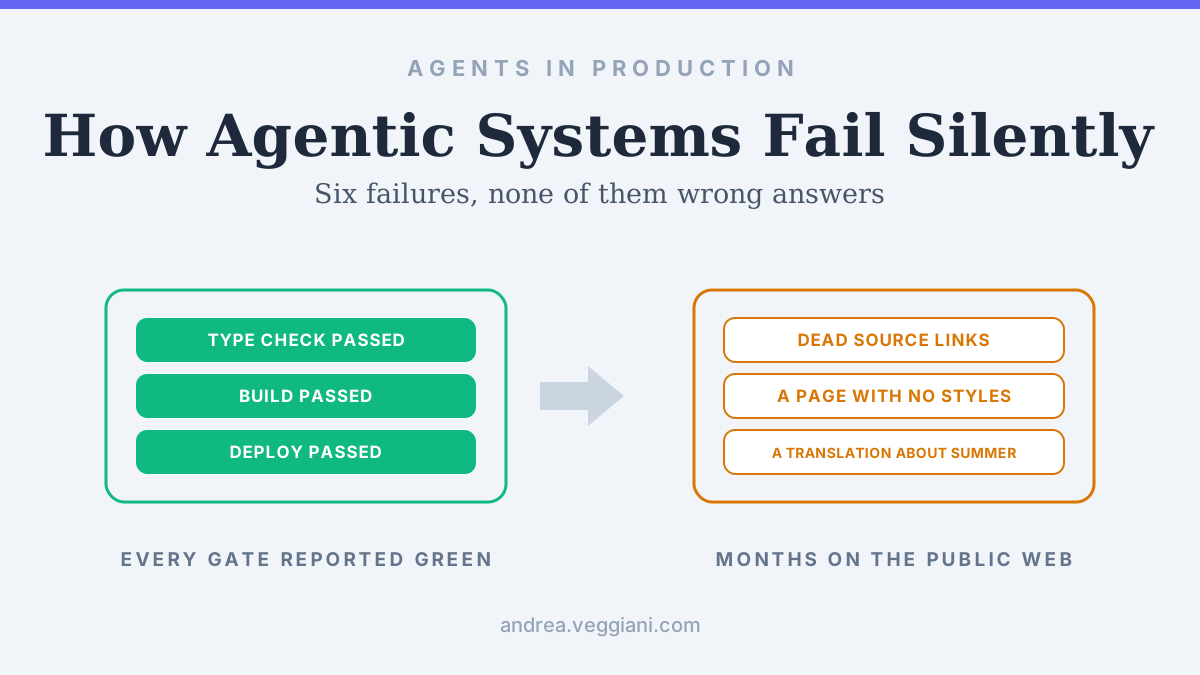
TL;DR: I guasti di questo sito che vale la pena pubblicare non sono mai stati risposte sbagliate. Erano output dall’aria corretta, che passavano ogni controllo automatico e uscivano rotti, in un caso per mesi. Qui sotto ce ne sono sei, insieme all’argomento che compongono: in un sistema agentico il livello dei controlli automatici è il livello di governance, e tutto il resto è burocrazia.
Il primo articolo della serie descriveva di cosa è fatto davvero un sistema agentico una volta finita la demo: un livello di contesto scritto, una memoria con una politica di scadenza e un’unica fonte di verità dichiarata. Questo articolo parla di cosa continua ad andare storto quando tutto questo è già a posto, e in particolare della classe di guasti che l’autonomia può peggiorare.
Una statistica allucinata è imbarazzante ed è anche, per fortuna, il caso facile: un’affermazione sbagliata tende a sembrare sbagliata a chiunque conosca la materia. Quello che mi è costato tempo davvero su questo sito è output strutturalmente corretto, che ha passato ogni verifica automatica ed era rotto in un modo emerso settimane dopo attraverso un canale che non aveva niente a che fare con la pipeline che lo aveva prodotto.
Posso pubblicarli perché il sito è mio e gli errori sono miei. Quasi nessuno dentro un brand può farlo.
Un link troncato resta markdown valido
Il pericolo di fondo è ambientale. Questo progetto vive su una macchina Windows e il lavoro passa da un ponte su quel filesystem, e ogni tanto una scrittura che dovrebbe aumentare le dimensioni di un file viene tagliata alla dimensione precedente del file. La coda si perde. Non viene sollevato nessun errore da nessuna parte.
Per il codice è rumoroso; un componente .astro tagliato a metà file non ha il tag di chiusura, il compilatore lo dice in parole chiare, e il guasto si risolve entro un minuto da quando compare. È successo più volte al footer, al foglio di stile globale, alla home italiana, e ogni volta si è annunciato da solo.
Per la prosa è completamente silenzioso, e la ragione sta in un dettaglio della specifica markdown, non nel modello. Un link tagliato a metà URL, con la riga che finisce ](https://example.com/some-repo (la parentesi di chiusura non arriva mai), resta un documento markdown perfettamente valido, e quello che rimane lì è testo letterale senza nessun link dentro. Il parser è del tutto contento, astro check passa, astro build passa, e il deploy esce.
Tre articoli sono usciti in quello stato e ci sono rimasti per diverso tempo. Non li ho trovati io. Li ha trovati un crawler esterno di link, molto dopo la pubblicazione, durante un audit di routine del sito: il primo segnale che la mia macchina editoriale avesse un problema di integrità dei dati è arrivato da fuori della macchina stessa.
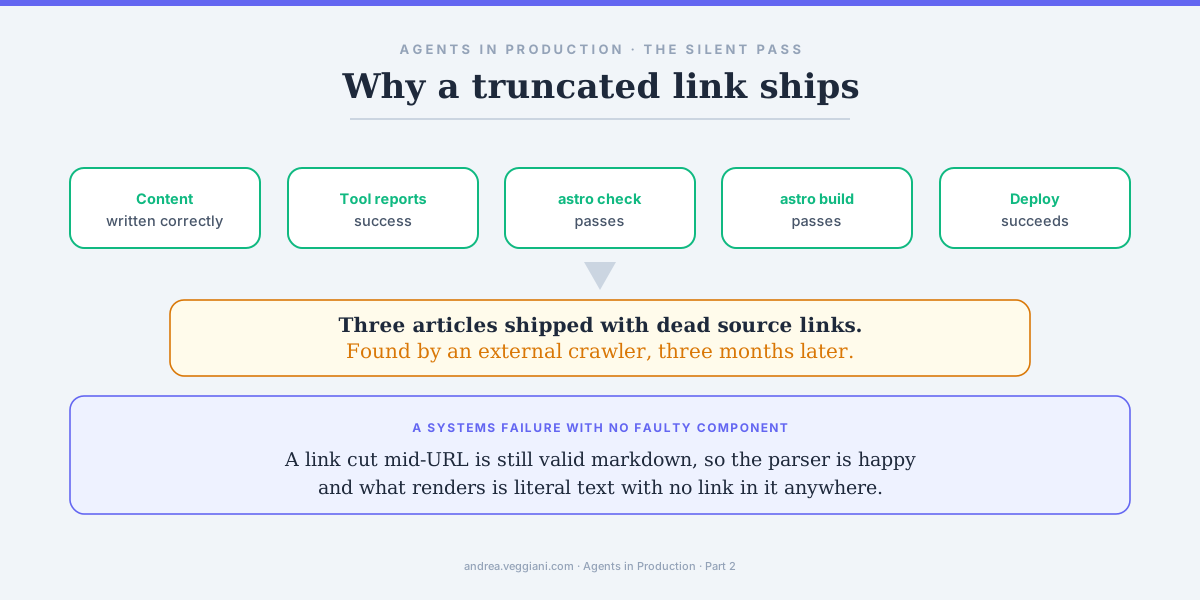
È facile archiviare tutto sotto “l’AI ha sbagliato” e non imparare niente. Il contenuto era corretto quando è stato scritto. Il tool ha riportato successo. Il controllo dei tipi è passato sul sorgente reale e completo. La build è passata. Il deploy è passato. Ogni componente si è comportato esattamente come progettato, e l’articolo era comunque sbagliato. È un guasto di sistema senza nessun componente guasto dentro, che è la stessa forma della maggior parte dei costosi guasti di integrazione che mi è capitato di diagnosticare negli stack dei clienti.
O il rimedio è deterministico, o non è un rimedio
L’istinto dopo un guasto così è stare più attenti. Stare più attenti non è un controllo, è un’intenzione, e si degrada nel momento in cui la settimana si fa pesante.
Al suo posto è entrato uno script. check-content.mjs è fatto di 248 righe di Node, scansiona ogni file markdown sotto le collezioni di contenuto e la cartella delle bozze, e cerca le firme specifiche di una scrittura tagliata: un link markdown non terminato, un autolink non terminato, parentesi quadre sbilanciate su una riga, byte NUL in qualsiasi punto del file, e un’ultima riga di contenuto che finisce a metà parola senza punteggiatura finale. Se trova qualcosa esce con codice diverso da zero.
La parte importante è dove sta. È il primo comando di npm run build, prima del controllo dei tipi, prima della build stessa, quindi un file troncato adesso fa fallire il deploy invece di uscire in silenzio. Il controllo è deterministico, costa poco, e non gli interessa come sia arrivato il danno.
Una decisione di progetto è quella che difenderei con più forza. Il controllo sulla coda a metà parola ha una whitelist: una fila di hashtag è il modo legittimo in cui finisce una bozza per i social, una riga di tabella finisce su un carattere alfabetico, una linea orizzontale non è una frase. Senza quelle eccezioni lo script segnalerebbe a ogni esecuzione. Un controllo che segnala sempre è un controllo che nessuno legge, e un controllo che nessuno legge è peggio di nessun controllo, perché converte un segnale reale in rumore di fondo lasciando tutti convinti che il problema sia coperto. Qualsiasi team di marketing che abbia mai silenziato un alert sulla qualità dei dati sa esattamente come va a finire.
Scrivere “causa ignota” e intenderlo davvero
Quando la troncatura è comparsa la prima volta ho fatto quello che fa chiunque abbia esperienza: ho formulato un’ipotesi che spiegava le prove. Due scrittori sullo stesso file, uno dei due dal lato Windows: un’estensione che formatta al salvataggio, un file watcher, la sincronizzazione cloud. Spiegava i tempi. Spiegava perché colpiva alcuni file e non altri. Era plausibile, era meccanicamente sensata, e l’ho scritta nelle istruzioni di progetto come la causa.
Era sbagliata. Non ho mai avuto la formattazione al salvataggio attiva. Un test diretto ad agosto non è riuscito a riprodurre nessuna troncatura: scritture che portavano un file da cinquanta byte a duecento kilobyte sono arrivate pulite, una scrittura da tool seguita da una modifica in append è arrivata pulita, e una passata sull’intero corpus di 149 file è arrivata pulita. Una parte separata della stessa teoria, che un errore di permessi in cancellazione indicasse un lock di Windows, si è rivelata una protezione di sicurezza del tooling senza alcun rapporto.
Quindi la nota nel file di progetto adesso dice, in maiuscolo, che la causa è ignota e che nessuno deve affermarne una. Dice anche esplicitamente che una versione precedente dello stesso file dava la colpa all’editor e non era supportata da niente, perché altrimenti una sessione futura legge un paragrafo dal tono sicuro e ricostruisce lo stesso modello sbagliato.
Nel repository resta un residuo di quell’errore, e l’ho lasciato lì di proposito. Il commento in testa a check-content.mjs spiega ancora la teoria del writer Windows come se fosse un fatto. È un fossile di una spiegazione superata, incastonato nell’unico pezzo di codice che intercetta davvero il problema reale, ed è un promemoria utile: l’artefatto può sopravvivere al ragionamento che lo ha prodotto.
Riconosco lo schema dal lavoro sull’attribuzione. Una storia causale plausibile che spiega i dati è la cosa più costosa che si possa adottare presto, perché ferma l’indagine, finisce nelle slide, e sopravvive a lungo dopo che le prove a suo favore sono evaporate. Il controllo che ha intercettato la troncatura funziona proprio perché non fa nessuna assunzione sulla causa. Cerca il danno.
Il guasto che un controllo di sintassi non vede
Tutto quello visto finora è strutturale, quindi una macchina lo trova. Questo no.
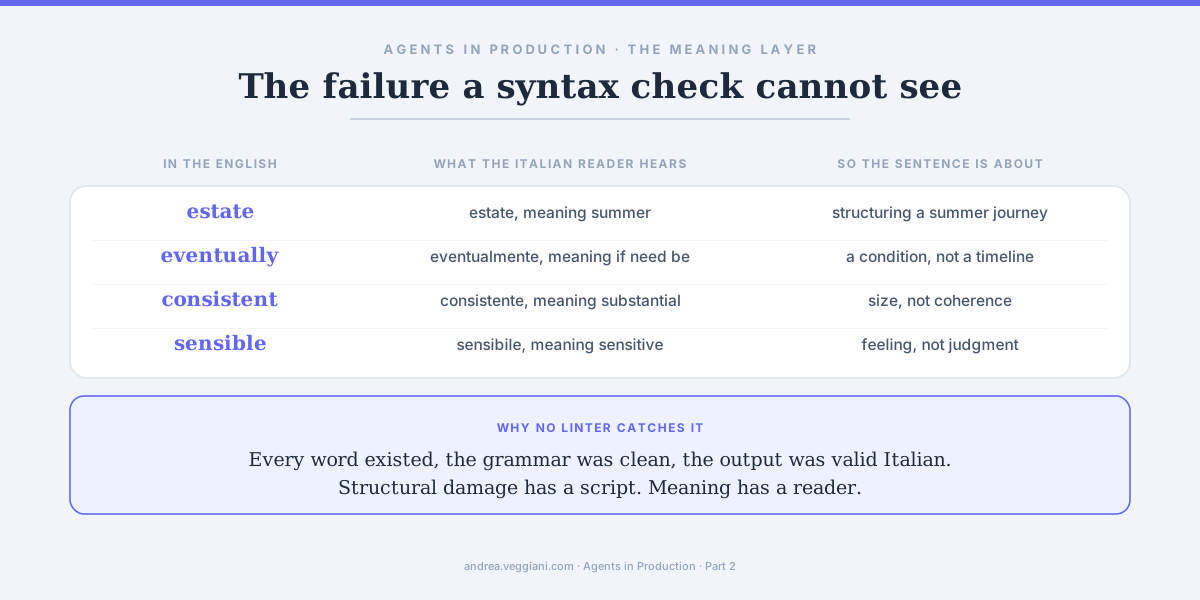
Pubblico in inglese e in italiano, e gli articoli italiani sono traduzioni degli originali inglesi. In uno di questi la locuzione journey estate, uso britannico per l’insieme dei journey che un brand gestisce, è rimasta in inglese sul giudizio del tutto corretto che fosse un termine tecnico. Estate è anche una parola italiana comune, e in italiano indica la stagione calda. La frase, letta da un lettore italiano senza memoria dell’inglese, gli diceva di strutturare un journey estivo.
Per questo non esiste un linter. L’output era italiano valido, ogni parola esisteva, la grammatica era pulita. Il guasto stava al livello del significato, e più precisamente al livello di quale significato un lettore italiano incontra per primo, che non è mai quello tecnico.
La stessa famiglia di errore corre anche nella direzione opposta, quando il termine viene tradotto e atterra sulla parola italiana sbagliata. Eventually diventa eventualmente, che vuol dire se necessario. Consistent diventa consistente, che vuol dire corposo e non coerente. Sensible diventa sensibile, che vuol dire delicato. Ognuno di questi produce una frase grammaticale, sicura di sé, e su un argomento diverso da quello che avevo scritto.
Le protezioni che esistono adesso non sono affascinanti e funzionano. Una tabella di falsi amici vive nelle regole di scrittura con una resa di casa dichiarata per ciascuno, così la decisione si prende una volta invece di essere ridiscussa a ogni articolo. I termini tecnici inglesi che collidono con parole italiane comuni hanno rese di casa proprie, e per il caso qui sopra quella stabilita è patrimonio. Una breve lista di prestiti resta in inglese di proposito, composable fra questi, perché tradurli produce qualcosa che nessun professionista italiano direbbe ad alta voce. E l’ultimo controllo prima che un articolo italiano esca è leggere ogni frase ad alta voce come farebbe un monolingue, senza memoria del testo di partenza, e notare dove atterra.
Quel controllo non è automatizzabile. Il danno strutturale ha uno script. Il significato ha un lettore.
La deriva visibile solo in aggregato
C’è una terza categoria che nessun articolo singolo rivela.
Ogni pezzo di questo sito che cita qualcosa finisce con una sezione Fonti, che è una convenzione piccola e del tutto meccanica: un’intestazione a un livello, gruppi in grassetto, punti elenco sotto, testo del link reale su ogni voce. Sei mesi di scrittura ne hanno prodotte quattro versioni diverse. Alcuni articoli intitolavano la sezione References, altri Sources and references, e qualcuno usava un H3 dove il livello di casa è un H2. Alcune voci erano diventate autolink nudi, con l’URL a fare da testo di se stesso, e una era scivolata in una lista numerata. I nomi dei gruppi avevano preso i due punti in certi posti e non in altri. Circa la metà aveva una riga vuota fra il nome del gruppo e il primo punto elenco dove il resto non ce l’aveva.
Nessuno di quegli articoli sembrava sbagliato preso da solo. Ogni variante era internamente coerente, si visualizzava pulita, e passava ogni controllo esistente, il che era facile perché il controllo che l’avrebbe intercettata non esisteva e non poteva esistere. Non c’era nessuna specifica scritta contro cui controllare. La deriva era visibile solo aprendo tutti e novantatré gli articoli insieme, cosa che nessuno fa nel corso di una settimana normale.
Il rimedio è stato specificare il formato per intero, in un posto solo, comprese le parti che sembrano troppo banali da mettere per iscritto, e poi normalizzare tutto il corpus in una passata sola ad agosto. La regola sui trattini lunghi ha avuto lo stesso trattamento, e adesso porta un’istruzione permanente di rimuoverli a ogni revisione invece di dipendere dal fatto che me ne accorga.
Quello che le vale un posto accanto ai link troncati è la sua forma. Presa una a una la deviazione è invisibile e difendibile. In aggregato è ovvia. E l’unica ragione per cui è diventata controllabile è che qualcuno alla fine si è seduto a scrivere la convenzione per intero, dopo sei mesi in cui esisteva solo come qualcosa che avrei riconosciuto vedendola.
Chi ha ereditato una tassonomia di campagne conosce questo guasto benissimo. Nessuno dà mai un nome sbagliato a una campagna. Tutti gliene danno uno leggermente diverso da quello di chi se n’è andato, e diciotto mesi dopo il livello di reporting poggia su una convenzione di naming che esiste in quattro dialetti mutuamente incompatibili, nessuno dei quali era un errore nel momento in cui è stato introdotto.
Quelli che si rompono per assenza
L’ultima categoria è la più difficile, perché sulla pagina non c’è niente di sbagliato. Manca qualcosa, e un’assenza non solleva un’eccezione.
Il layout di questo sito ricava l’immagine di anteprima social prendendo l’immagine di apertura dell’articolo e scambiando l’estensione con .png, perché LinkedIn e X non sanno visualizzare SVG né WebP. Lo scambio è cieco. Se un’immagine di apertura non ha un fratello PNG allo stesso percorso, l’anteprima di condivisione punta a un file che non esiste, e la pagina non ha nessun modo di saperlo. Quattro post sono rimasti così finché non ho controllato, compresi, con una certa ironia, tutti e due i pezzi sulla demo di Braze. Quel controllo adesso sta nello stesso script che intercetta le troncature.
L’altro ha richiesto giorni. Astro aggrega il CSS raggiungibile da una pagina sola in un chunk a sé, e due pagine senza rapporto fra loro possono collidere sullo stesso nome di chunk, e a quel punto una delle due sparisce in silenzio dall’output costruito. Nessun errore, nessun avviso, sorgente corretto. La home italiana ha perso gli stili così, mentre quella inglese si costruiva bene. Mesi dopo lo stesso meccanismo ha colpito due componenti condivisi e ha tolto in silenzio la card della newsletter dal footer della home e dall’hub di Weekly Signals.
Tutti e due hanno la stessa forma di un tag di tracciamento che non è mai partito e di un flag di consenso che non è mai stato scritto. Il sistema non ha nessuna rappresentazione della cosa che avrebbe dovuto esserci, quindi non può dirvi che manca, e ogni dashboard riporta OK.
Anche i rilevatori mentono. Quando un crawler esterno ha segnalato undici link in uscita morti su questo sito, sette si sono rivelati editori che bloccano le richieste automatiche, e i link funzionavano benissimo da browser. Ognuno è andato verificato contro una fetch di controllo sullo stesso host prima di toccare qualcosa. Un alert non verificato è il modo in cui si finisce a riscrivere articoli corretti.
Dove vive davvero la governance
Messi insieme, i sei si ordinano in quattro gruppi. Danno strutturale, che uno script trova. Danno semantico, che trova solo un lettore madrelingua o un grep mirato. Deriva stilistica, che ha bisogno di una regola dichiarata e di una passata sul corpus. E assenza, che ha bisogno di un controllo che sappia cosa dovrebbe esserci.
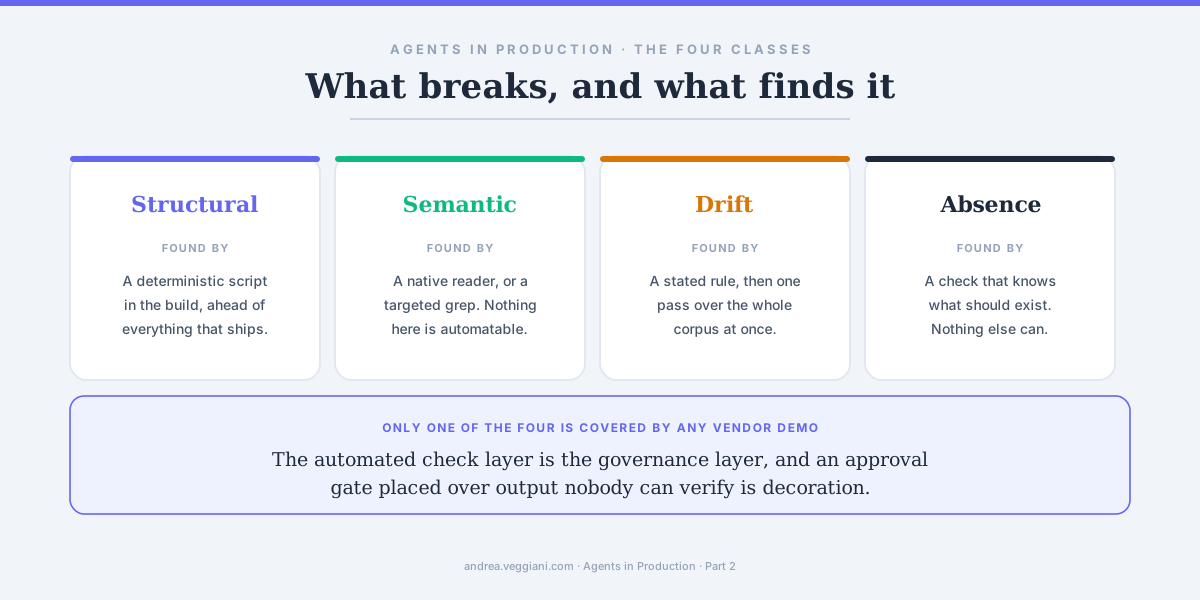
Di quei quattro, uno solo è coperto da qualcosa che un vendor mostra in demo.
La conclusione che mi sono riportato nel lavoro con i clienti è scomoda da dire in riunione. In un sistema agentico il livello dei controlli automatici è il livello di governance, e il passaggio di approvazione umana vale solo quanto chi revisiona riesce davvero a verificare. Una persona che clicca approva su un lotto di varianti generate, ai volumi che questi sistemi producono, non sta esercitando un giudizio. Sta assorbendo responsabilità per un campione che non ha letto. Se il controllo che avrebbe intercettato il guasto non esiste dentro la pipeline, il cancello di approvazione sopra di esso è decorazione, e il fatto che qualcuno abbia firmato rende più bello l’audit trail e lascia il risultato identico.
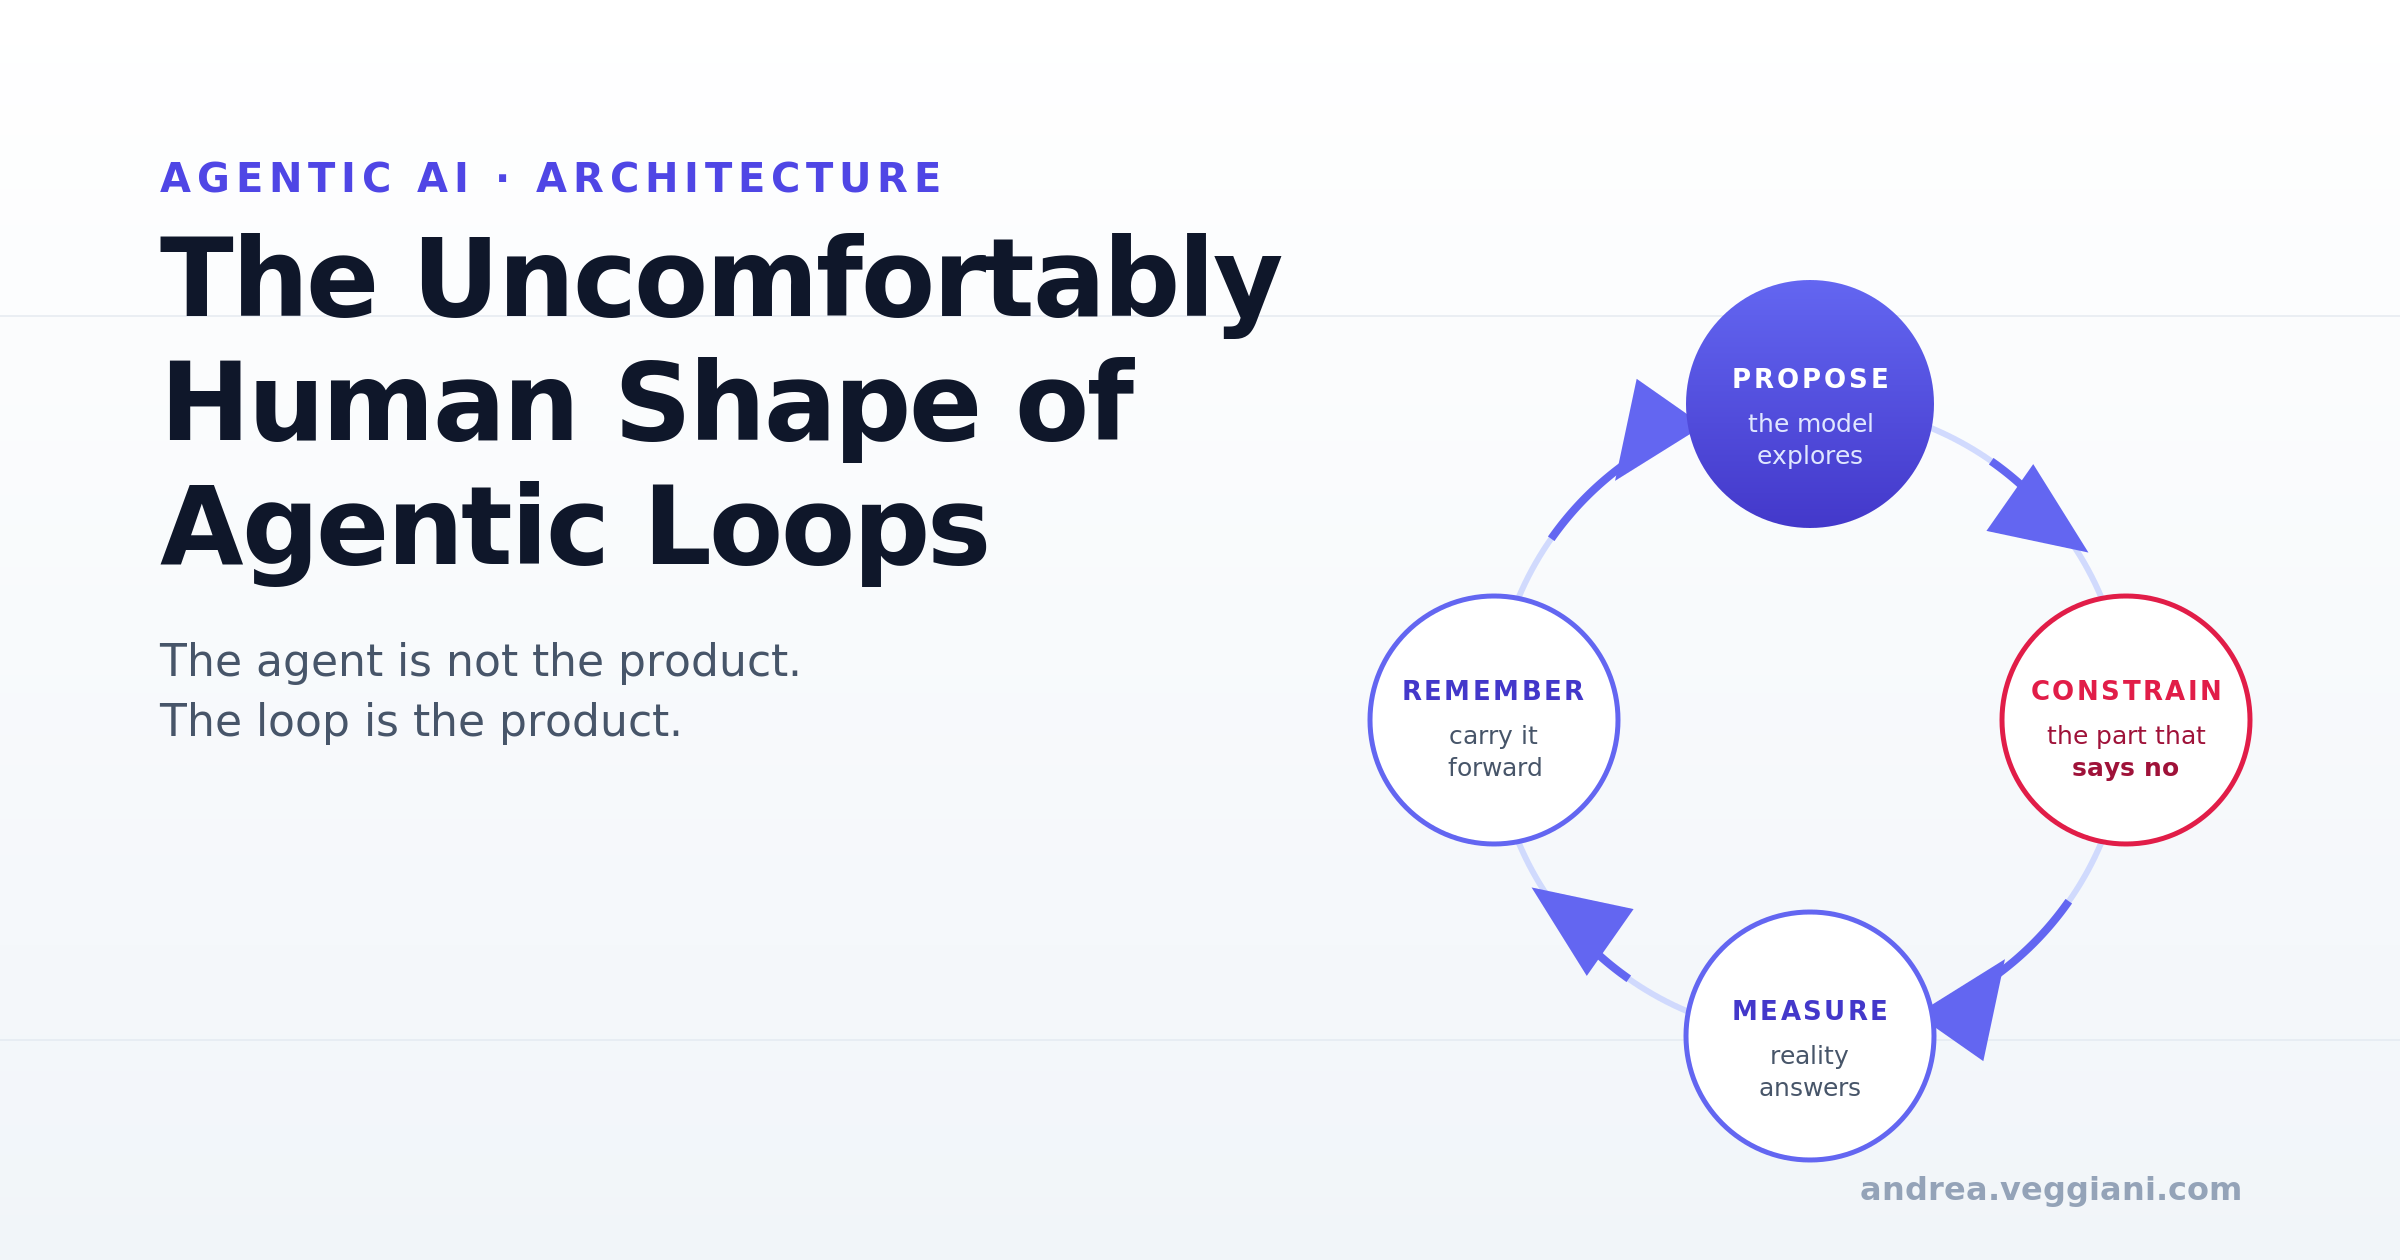
In The Uncomfortably Human Shape of Agentic Loops scrivevo che il componente più importante di un loop agentico è la parte che dice di no. I mesi passati a farne girare uno non mi hanno fatto cambiare idea, mi hanno solo reso più specifico. La parte che dice di no deve essere deterministica, deve girare prima della cosa che pubblica, e deve costare abbastanza poco perché nessuno sia tentato di saltarla di venerdì.
Quindi, quando un vendor vi mostra cosa sa produrre il suo agente, la domanda che vale la pena fare è che cosa si rifiuta di pubblicare?, e chi ha scritto quel rifiuto.
Il terzo e ultimo articolo della serie parla del livello sopra i controlli: come il lavoro editoriale ricorrente su questo sito è diventato procedure con un nome, con i propri limiti, cancelli e regole di approvazione, e dove il paragone con la journey orchestration smette onestamente di reggere.
Fonti
Specifiche
- CommonMark specification. Il comportamento di parsing che fa visualizzare un link troncato come testo letterale invece che come errore.
- Astro content collections. Il livello di schema che valida il frontmatter degli articoli, e scarta in silenzio qualsiasi campo non dichiarato al suo interno.