Questo articolo è una traduzione assistita dall’AI dell’originale in inglese, revisionata dall’autore.
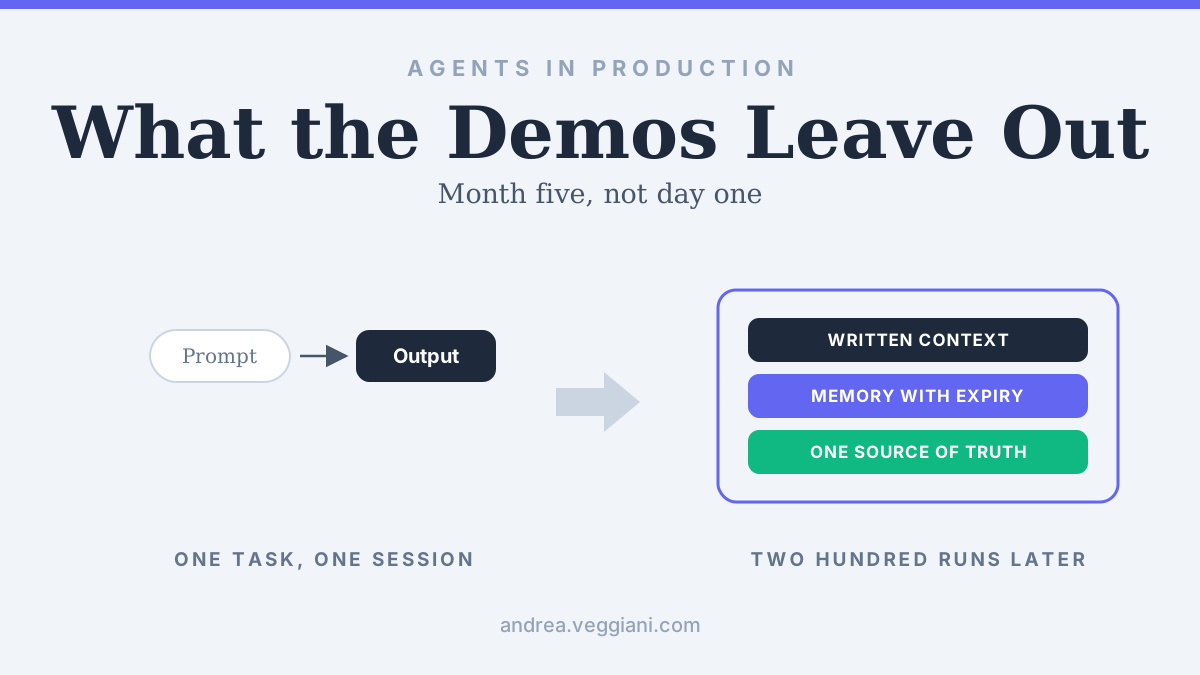
TL;DR: Le demo agentiche dei vendor mostrano un compito che si chiude dentro una sessione. Quello che decide se un sistema agentico sopravvive è come si presenta al quinto mese, e a quel punto quasi niente del lavoro è prompting. È un livello di contesto scritto, una memoria che scade e un workspace con un’unica fonte di verità non ambigua.
Ogni demo agentica a cui ho assistito quest’anno ha la stessa forma. Entra un prompt, scorre una colonna di tool call, e alla fine compare qualcosa: un segmento, un journey, una serie di varianti di subject line, un brief di campagna. La demo è reale, l’output di solito è buono, e la sala resta colpita. Poi la demo finisce, e la domanda che sono pagato per fare per conto di un cliente in quella stanza non la fa mai nessuno: come si presenta lo stesso sistema al quinto mese, dopo duecento esecuzioni, dopo che ci hanno messo mano tre persone diverse, quando in azienda nessuno ricorda più cosa dicesse il prompt originale né perché lo dicesse.
Ho cominciato a rispondere partendo dalla mia esperienza invece che dal materiale dei vendor, per una ragione semplice: ho esattamente un sistema agentico che controllo dall’inizio alla fine e di cui posso raccontare gli interni.
A marzo 2026 ho ricostruito questo sito in un fine settimana con Astro, Vercel e Claude, e l’ho raccontato come un esperimento di ritorno alla costruzione dopo due decenni di deriva dalla tastiera verso la lavagna, in What a Weekend with Astro and Claude Cowork Taught Me About Building Again. Quel pezzo era onesto su cosa fosse: la storia di una build. Cinque mesi dopo è anche un po’ fuorviante, perché la build era la parte facile e si è chiusa in tre giorni. Quello che è venuto dopo è una macchina editoriale che gira ogni settimana, e si è rivelata avere pochissimo a che fare con la build.
La demo finisce esattamente dove comincia il problema interessante
Le demo a sessione singola convincono perché rimuovono tutte le variabili che rendono difficile il lavoro agentico. C’è un compito solo, quindi non si pone la questione della coerenza fra compiti diversi. C’è una sessione sola, quindi non c’è niente da ricordare. C’è un operatore solo, che guarda caso è la persona che ha progettato la demo, quindi le istruzioni sono calibrate al millimetro sulla richiesta. E non c’è archivio, quindi niente di prodotto il mese scorso deve restare coerente con quello che si produce oggi.
Le macchine vere hanno tutte e quattro le cose. La cadenza settimanale di questo sito produce lavoro che deve somigliare a quello di dodici settimane fa, in due lingue, con un formato di serie di cui il lettore noterebbe l’assenza. Niente di tutto questo è difficile in una sessione singola, e tutto lo diventa alla novantesima.
È la parte delle promesse sul marketing agentico coperta peggio, e di come leggerle con scetticismo ho già scritto in Judging Agentic Marketing Claims. Lo scetticismo che voglio aggiungere qui è più stretto e più pratico. Chiedete a un vendor cosa legge il suo agente prima di partire, cosa scrive quando ha finito, e cosa succede quando le due cose non concordano. Le risposte dicono molto di più sulla tenuta in produzione di qualsiasi numero di esecuzioni in demo.
Com’è fatta la macchina
Ecco come si presenta ad agosto 2026.
Il sito ospita novantasei articoli, sessantaquattro in inglese e trentadue in italiano, insieme a quattordici record datati di MarTech Watch, quattro di AI Watch e cinque nodi di Architecture Literacy. Quattro serie corrono in parallelo, ognuna con una sua spina dorsale strutturale: Field Notes on CEP con la sua sequenza fissa di vendor, The Architecture Behind the Acronyms con i suoi quattro movimenti, Weekly MarTech Signals con il suo formato da digest e il suo tetto di lunghezza, Weekly AI Tools con un perimetro più stretto. Ogni articolo pubblicato porta un’immagine di apertura con i formati companion, una sezione Fonti in una forma sola, e una serie di link interni intrecciati nel testo. Le nuove uscite partono come bozza di newsletter, e una versione teaser troncata va su Medium con il canonical che punta a casa.
Niente di tutto questo è particolarmente interessante. Quello che conta è che sia tutto ricorrente, e la ricorrenza è ciò che manda in crisi il lavoro agentico.
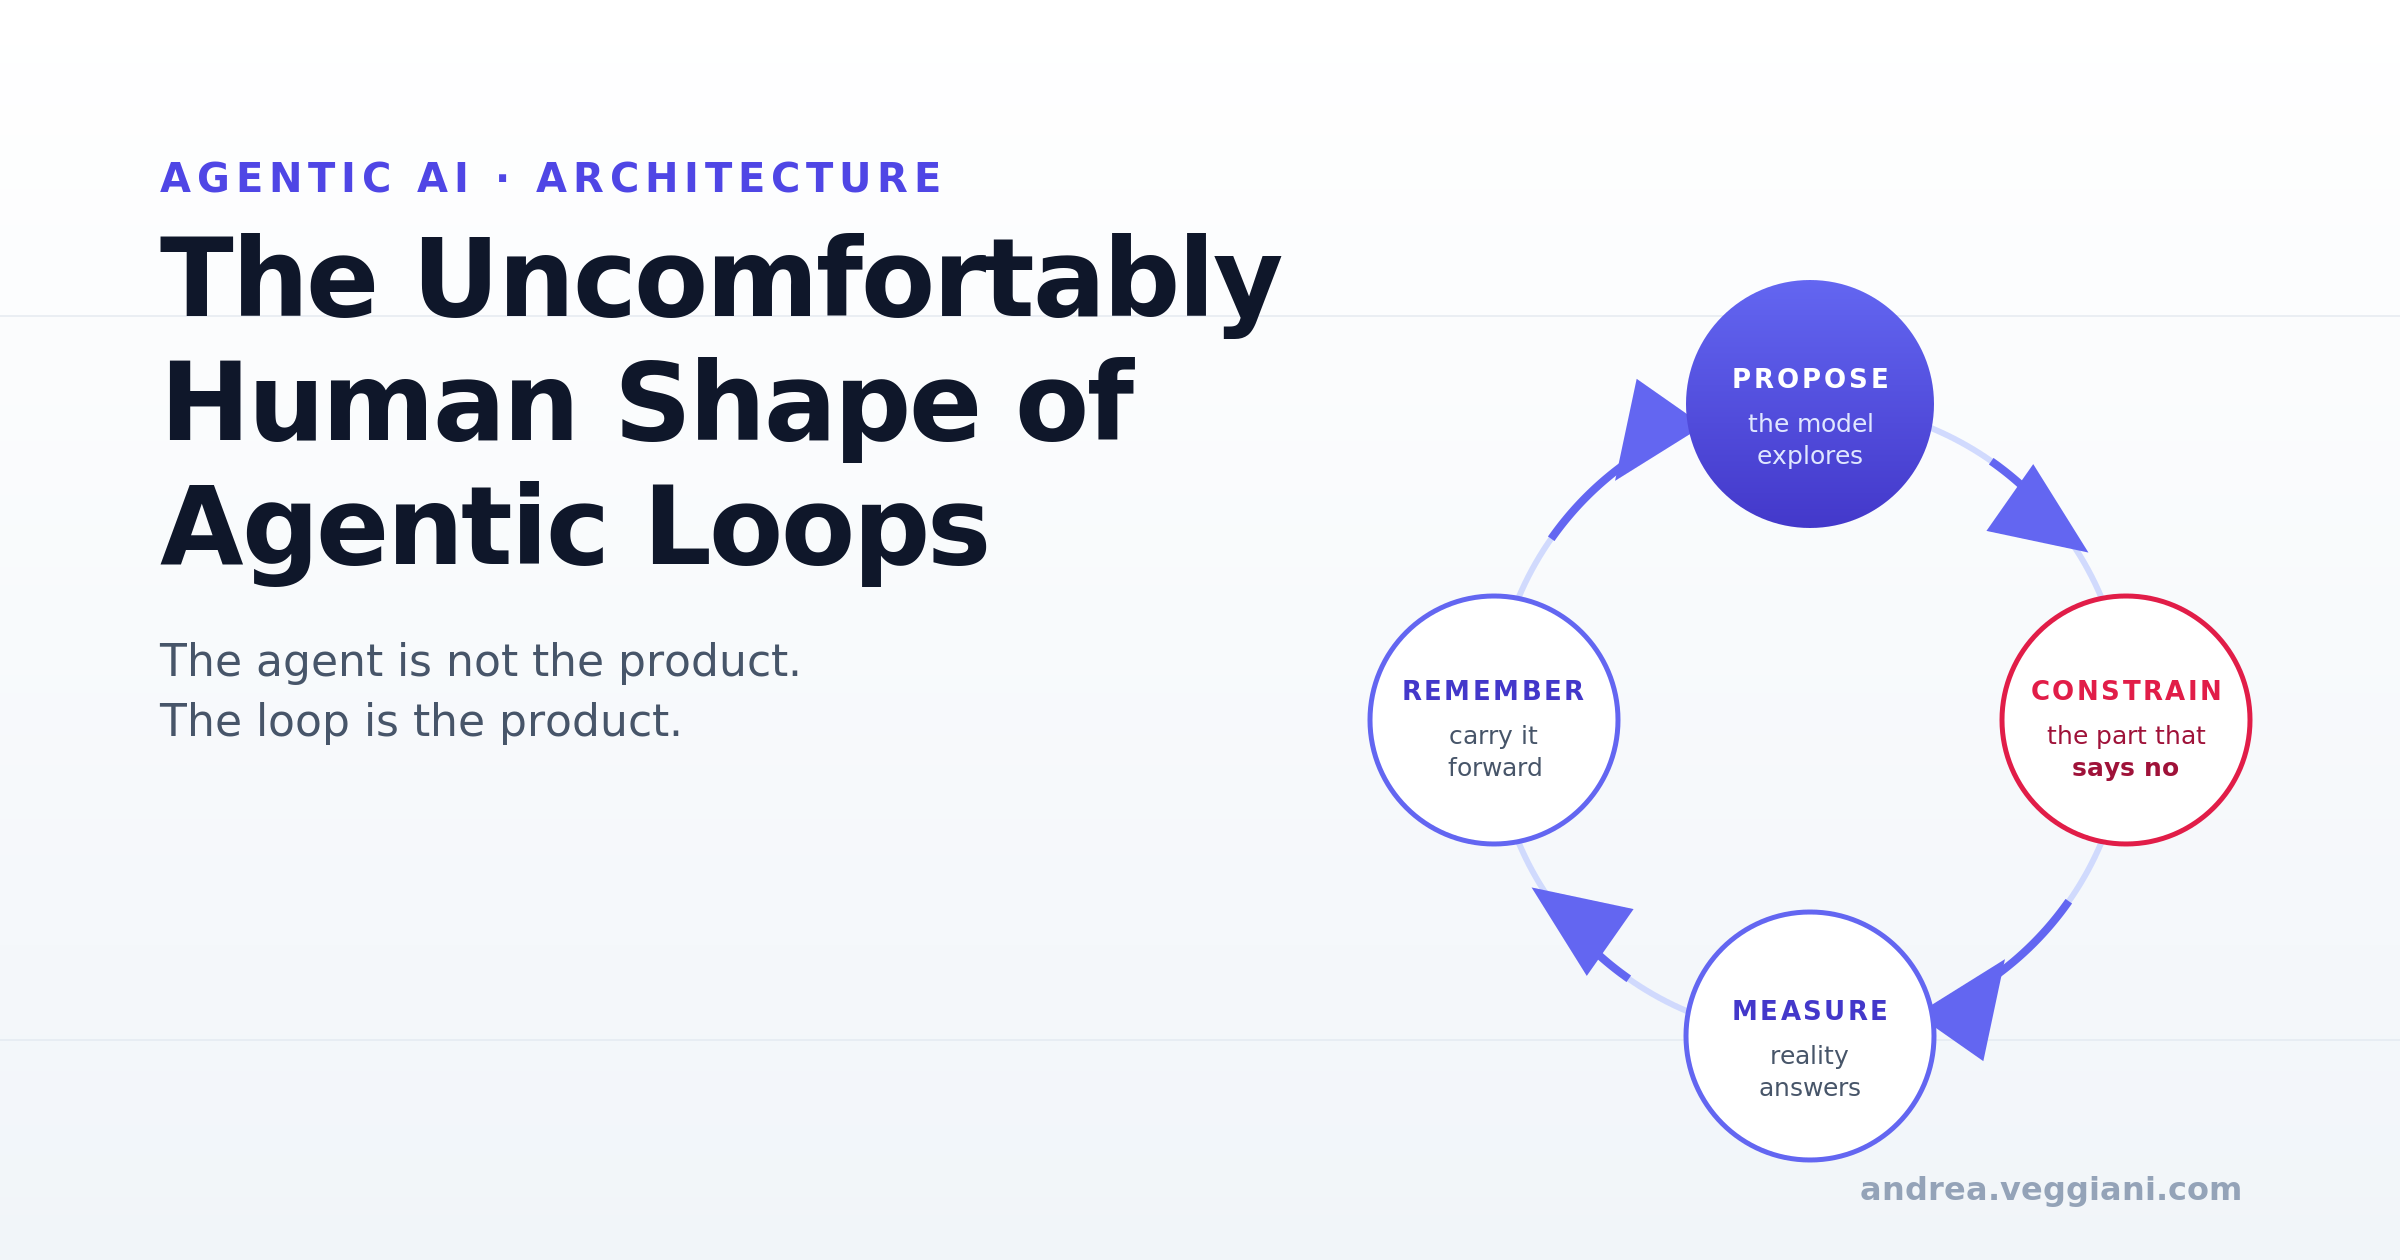
La sessione settimanale non comincia quasi mai con me che descrivo cosa voglio. Comincia con me che nomino una procedura e indico un file, e la procedura si porta dietro le regole: il tetto di lunghezza, la revisione della voce, la rimozione dei trattini lunghi, il controllo di conformità delle Fonti, la generazione delle immagini in tre formati. A come sono costruite quelle procedure torno nel terzo articolo della serie. Il punto qui è che dopo cinque mesi il rapporto si è invertito. A marzo ero io a fare prompting e il sistema eseguiva. Adesso il sistema esegue regole che ho scritto settimane fa, e il prompting è uno strato sottile sopra un substrato scritto molto più grande.
A un collaboratore che non ricorda nulla serve una specifica
La cosa più utile che ho fatto in questo progetto è stata accettare, presto e senza discuterne, che il mio collaboratore ricomincia da zero a ogni sessione.
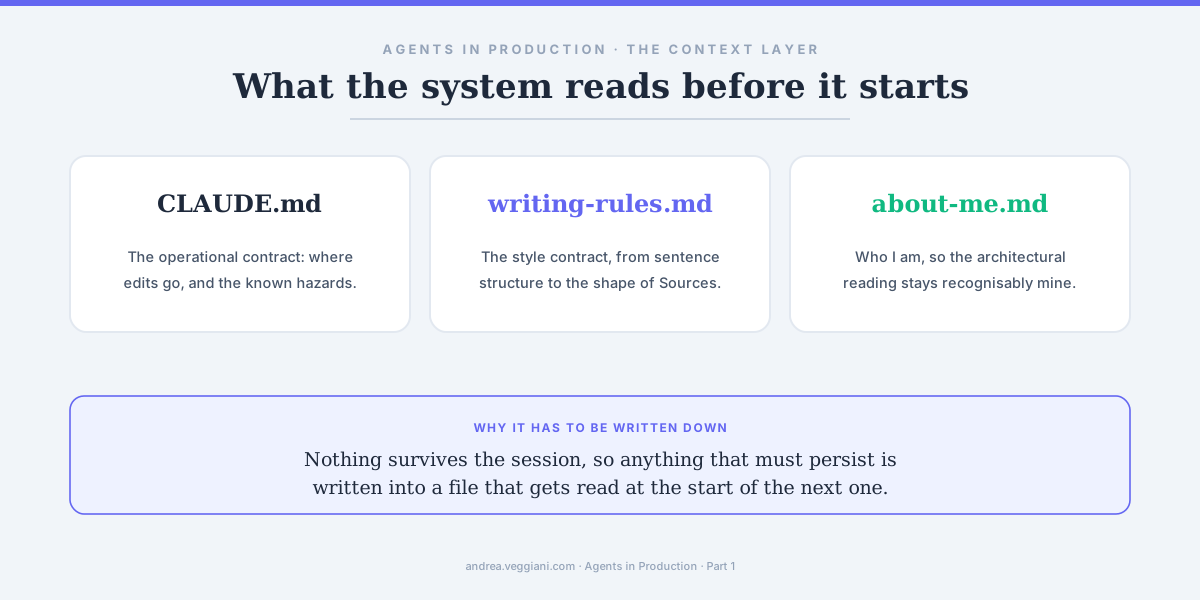
Sembra un limite, e lo è, ma impone una disciplina che poi si rivela essere tutto il trucco. Se niente sopravvive alla sessione, allora qualsiasi cosa io voglia conservare va scritta in un file che venga letto all’inizio della sessione successiva. Sono tre i file che reggono questo peso. CLAUDE.md tiene il contratto operativo: dove è consentito modificare, i rischi noti del filesystem, il flusso di build, le convenzioni che altrimenti verrebbero riscoperte a fatica ogni volta. writing-rules.md tiene il contratto di stile, dalla struttura della frase alla forma esatta di una sezione Fonti. about-me.md tiene chi sono e cosa faccio, così che la lettura architetturale resti riconoscibilmente mia.
Quello che non mi aspettavo è l’effetto che scrivere quei file ha avuto su di me, più che sul sistema.
Ho opinioni sulla punteggiatura da venticinque anni. Non ho mai avuto bisogno di formularle. Metterle per iscritto ha trasformato una preferenza in qualcosa di verificabile, il che mi ha costretto a decidere quale fosse davvero, e la prima versione della regola sui trattini lunghi era sbagliata perché vietava un carattere invece di descrivere il comportamento che non mi piaceva, cioè infilare incisi a metà frase invece di ristrutturare il periodo. Con le regole per l’italiano è andata allo stesso modo. “La CEP” è femminile e l’ho sempre detto, ma finché non l’ho scritta in un file non mi ero accorto di non saper spiegare la regola che la produce, solo il caso singolo.
Chi ha condotto una selezione di piattaforme sa di cosa si tratta. È il cliente la cui logica di segmentazione vive interamente nella testa dell’unica analista che l’ha costruita, e funziona benissimo fino al giorno in cui lei accetta un altro lavoro. In un setup agentico il modello scritto è il sistema che lavora, perché non c’è nient’altro che tenga insieme la logica da una sessione all’altra.
La memoria è stato, e uno stato obsoleto è peggio di nessuno stato
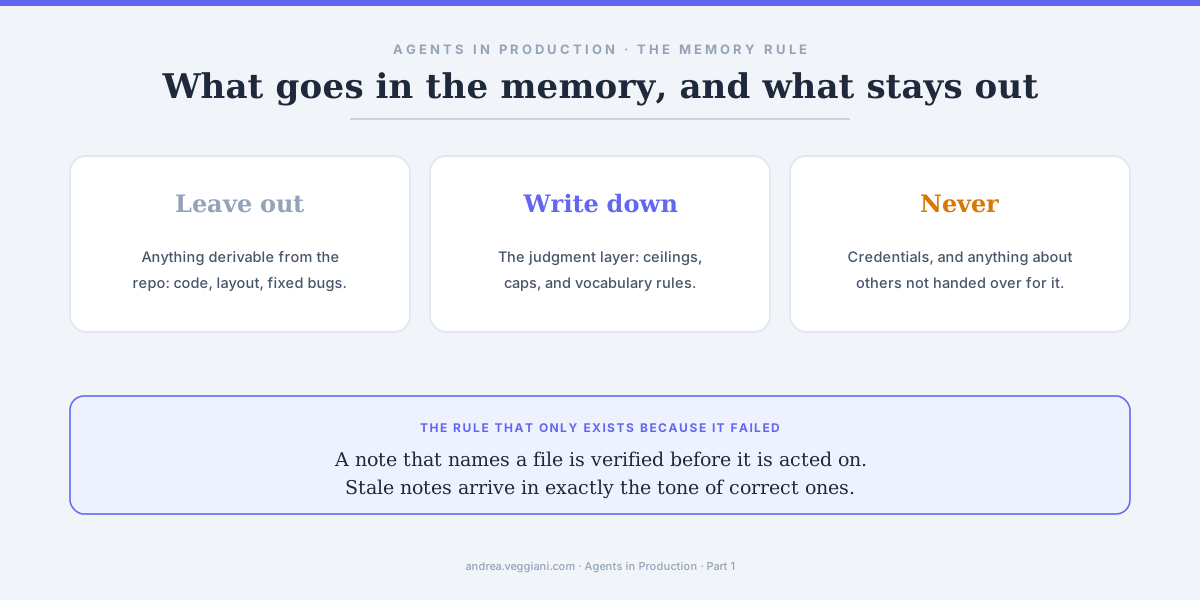
Accanto ai tre file di contesto c’è una memoria persistente, un insieme di note brevi con un indice che viene caricato all’inizio della sessione. La regola su cosa ci finisce dentro è semplice da enunciare e fastidiosa da applicare: scrivere solo ciò che non è deducibile dal repository.
La struttura del codice non entra, perché il codice è lì. I bug risolti non entrano, perché per quello c’è la history. Entra il livello di giudizio: il tetto numerico che tiene leggibile un’infografica, il limite strutturale che tiene la serie settimanale alla dimensione giusta, le piccole regole di vocabolario che fanno suonare l’italiano come italiano invece che come inglese decodificato. Da dove vengono quei numeri, e perché sono numeri e non aggettivi, è il tema del terzo articolo della serie. Qui conta che niente di tutto ciò sia deducibile dai file, e che tutto sia costoso da ricavare una seconda volta.
Il problema difficile non è cosa scrivere, ma la scadenza.
Una nota scritta a giugno che nomina un componente poi confluito in un altro manderà la sessione di oggi con assoluta sicurezza su un percorso che non esiste più, e lo farà con lo stesso tono di una nota ancora corretta. Ho dovuto cancellare memorie che erano vere quando le avevo scritte. Adesso c’è un’istruzione permanente: se una nota nomina un file o un flag, la sessione verifica che esista ancora prima di agire. È un controllo che esiste solo perché il guasto è successo.
Se suona familiare è giusto così, perché è il problema più vecchio dei dati di clientela vestito da un’altra parte. Un flag “recent purchaser” di quattordici mesi fa è un fossile, e un sistema che non sa distinguere un fossile da un segnale vivo personalizzerà su quel fossile con totale sicurezza. Ogni implementazione di CDP su cui ho lavorato ha avuto la sua versione di questa discussione, di solito tardi, di solito dopo che qualcuno aveva mandato una campagna di win-back a persone che avevano comprato la settimana prima. Costruire un sistema agentico mi ha rimesso in quella discussione dall’altro lato del tavolo, e adesso ho più comprensione per quanto sia facile rimandarla.
C’è una seconda regola sulla memoria che vale la pena enunciare: alcune cose non vengono scritte, deliberatamente. Le credenziali, ovviamente, ma anche qualsiasi cosa riguardi altre persone che non me l’abbiano consegnata per quello scopo. Un livello di memoria è una superficie di raccolta dati, e va governato come tale dal primo giorno, non dal giorno in cui qualcuno se ne accorge.
L’ambiguità è il guasto che costa di più e si annuncia di meno
Quando ho aperto la cartella del progetto quel primo fine settimana non era vuota. Conteneva foxi-astro-theme, astro-paper, astrofy e una cartella chiamata semplicemente site, che erano quattro serate di valutazione iniziate e mai concluse. Ho scelto foxi, ho creato personalSite e ho cominciato a lavorare.
Ognuna di quelle altre cartelle accetta volentieri una modifica, senza protestare. Una modifica scritta dentro foxi-astro-theme sembra riuscita esattamente quanto una scritta dentro personalSite, fino al momento in cui ricostruisci il sito e non si è mosso niente.
Per questo la prima riga di CLAUDE.md è una regola su quale sia la cartella vera, e c’è perché ho dovuto dirlo ad alta voce più di una volta. Un agente non vi dirà che il vostro workspace è ambiguo. Date quattro posizioni plausibili e nessuna fonte di verità dichiarata, ne sceglierà una, agirà con decisione e riporterà successo. Il guasto non sta nel ragionamento ma nell’ambiente, che il ragionamento ha riprodotto fedelmente.
Cosa si trasferisce, e cosa funziona solo perché sono una persona sola
Qui voglio andarci cauto, perché il modo tipico in cui un articolo come questo fallisce è un professionista che generalizza a partire da un setup privo di tutti i vincoli che rendono difficile il lavoro in azienda.
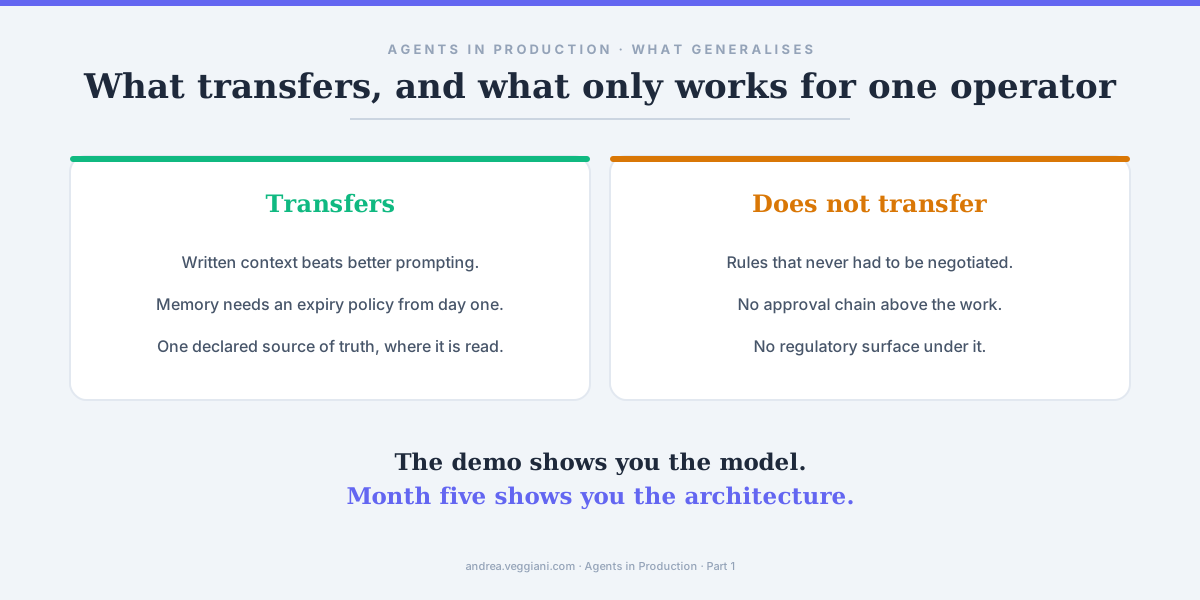
Tre cose si trasferiscono. Il contesto scritto batte il prompt migliore, e lo sforzo rende di più sui file che un sistema legge che sulle frasi che gli si digitano dentro. La memoria ha bisogno di una politica di scadenza dal primo giorno, perché una nota obsoleta non è una versione più piccola di una nota corretta. E un workspace ha bisogno di un’unica fonte di verità dichiarata, scritta dove il sistema la legge davvero, non data per scontata da chiunque sia lì da abbastanza tempo per saperla.
Tre cose non si trasferiscono. Sono un operatore solo, quindi il mio file di regole non ha mai dovuto essere negoziato, e in qualsiasi organizzazione quella negoziazione non è un costo accessorio del lavoro: è il lavoro. Non ho catena di approvazione né esposizione normativa, quindi il mio guasto peggiore mi costa una correzione e una serata di imbarazzo, non la lettera di un’autorità. E posso pubblicare i miei errori, che è una libertà che nessun brand ha, ed è gran parte del motivo per cui esiste così poco materiale onesto su come sono fatti davvero i sistemi agentici una volta finita la demo.
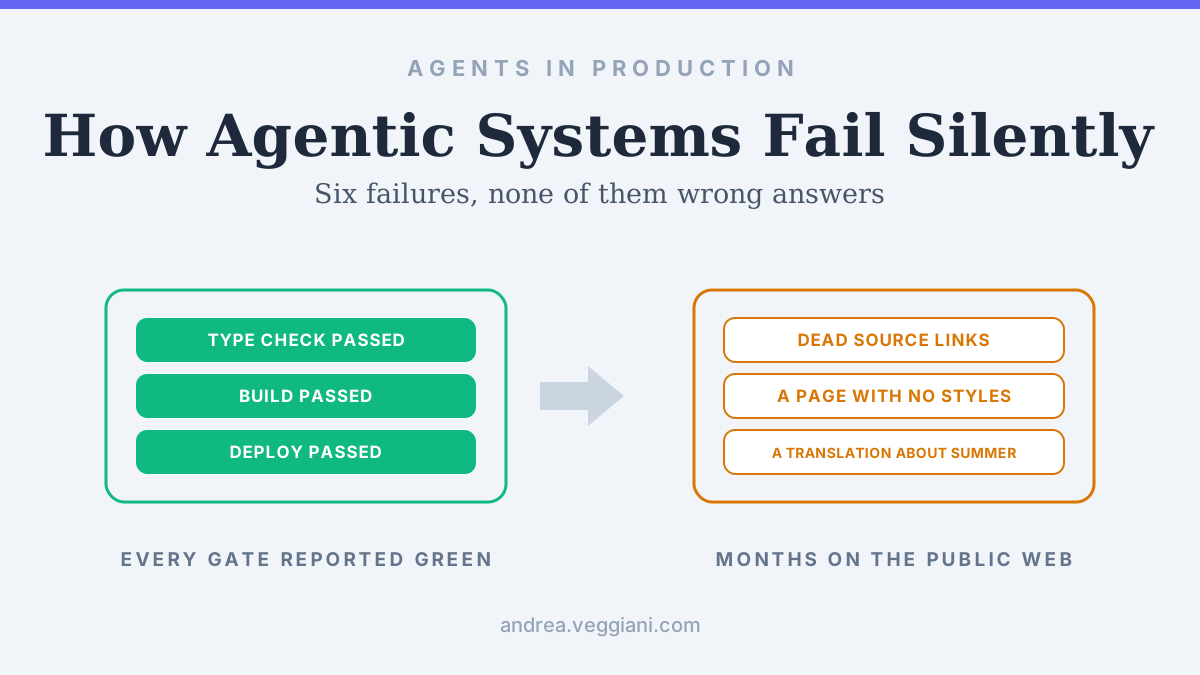
Su quest’ultimo punto qualcosa posso fare, quindi il prossimo articolo della serie è la lista dei guasti: sei fallimenti di questo sito, nessuno dei quali era una risposta sbagliata, compresi tre articoli che per mesi hanno avuto link alle fonti ormai morti mentre ogni controllo automatico dava verde.
La demo vi mostra il modello. Il quinto mese vi mostra l’architettura.
Fonti
Anthropic
- Introducing Claude Skills. Il formato di istruzioni impacchettate su cui sono costruite le procedure descritte qui.
Astro
- Content collections. Il livello di schema dietro le collezioni di articoli, watch e literacy citate sopra.