Questo articolo è una traduzione assistita dall’AI dell’originale in inglese, revisionata dall’autore.
Il marketing warehouse-native ha abituato il settore a considerare ogni copia dei dati cliente un difetto architetturale. Ridurre le copie ha senso quando si calcola un’audience, ma una piattaforma di engagement che deve decidere cosa mostrare in un’app ha poche centinaia di millisecondi a disposizione e altre esigenze da soddisfare.
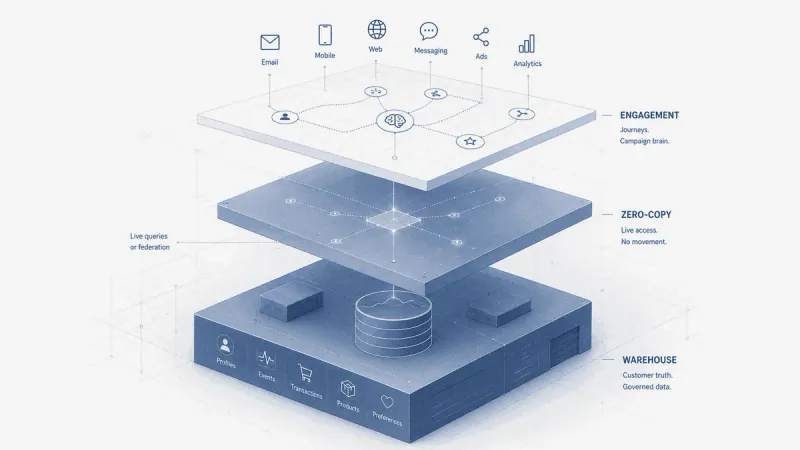
Negli ultimi tre anni, ridurre le copie inutili è stato uno degli obiettivi centrali dell’architettura dei dati cliente. Le CDP tradizionali richiedevano di replicare i dati in un database proprietario, introducendo ritardi di sincronizzazione, duplicazioni nello storage e una seconda definizione del profilo cliente. I pattern composable, il reverse ETL e la condivisione zero-copy hanno riportato il warehouse al centro dell’architettura, una scelta che ho sostenuto in Zero-Copy Engagement: quando il warehouse diventa la mente della campagna.
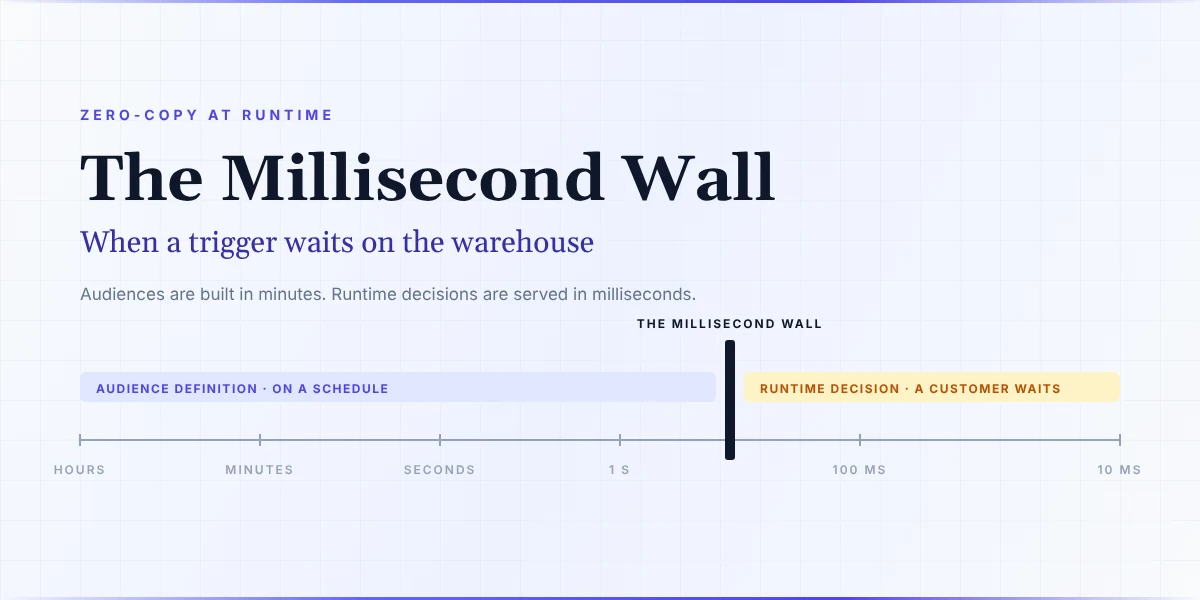
Questa scelta funziona per le analisi e le campagne pianificate. Calcolare la frequenza di acquisto negli ultimi trenta giorni, lo score di propensione al churn o l’audience della settimana successiva direttamente in Snowflake, Databricks o BigQuery evita passaggi intermedi e semplifica la governance. Il problema nasce quando si conclude che il warehouse, siccome sa definire un’audience, debba anche rispondere a ogni richiesta del runtime di engagement mentre il cliente aspetta. Su una slide i due compiti possono sembrare simili, ma richiedono al database prestazioni molto diverse.
Calcolare un’audience e decidere a runtime richiedono prestazioni diverse
L’audience di una campagna outbound viene calcolata a intervalli pianificati, con tempi nell’ordine dei minuti o delle ore. Un job legge lo storico delle transazioni, applica le regole di segmentazione e produce una lista di identificativi cliente: che impieghi quaranta secondi o quattro minuti non cambia nulla per la campagna. I motori con storage a colonne sono progettati proprio per queste elaborazioni, che leggono in parallelo grandi volumi di dati compressi.
Quando la decisione va presa a runtime, i vincoli cambiano. Un cliente apre l’app, visita tre categorie, aggiunge un prodotto al carrello ed esce; la piattaforma di engagement deve decidere se inviare una notifica push, cosa raccomandare e se applicare uno sconto. Le serve lo stato aggiornato del cliente: identità, requisiti di accesso all’offerta, contatori di frequenza ed eventualmente uno score. Se ogni informazione richiede una query al warehouse analitico, bisogna attendere la disponibilità delle risorse di calcolo, eseguire un lookup sul singolo cliente e ricevere il risultato. Un tempo di risposta eccellente per un report può così essere troppo lungo per un messaggio in-app o per un banner web da mostrare subito.
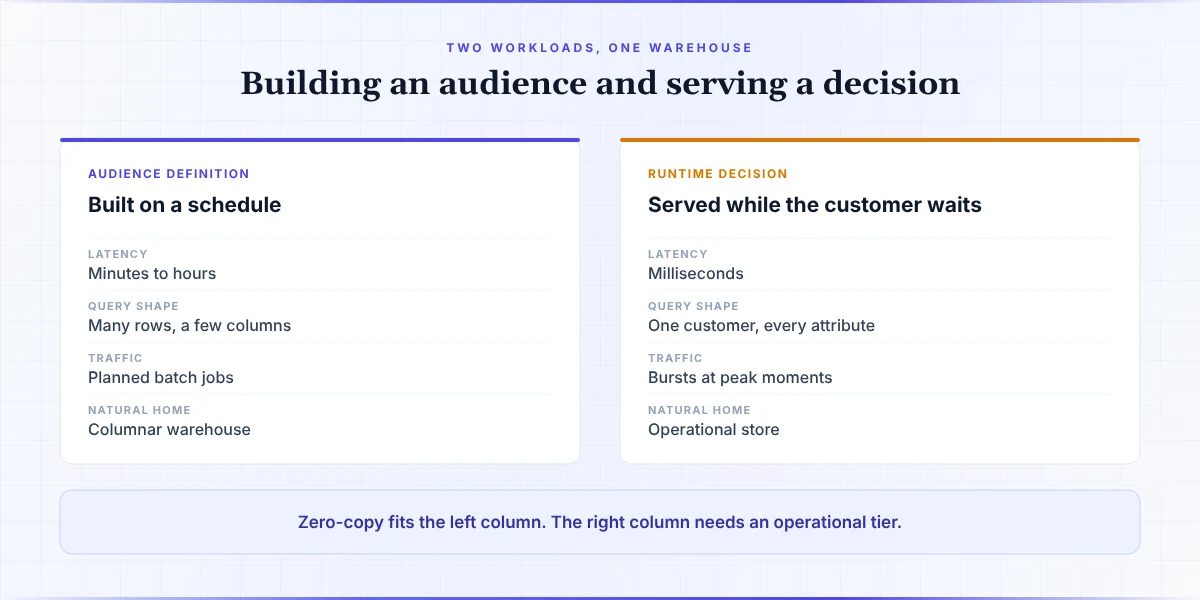
Figura 1. Un warehouse adatto a calcolare l’audience può non garantire i tempi necessari per decidere durante l’interazione con il cliente.
Il budget di latenza dell’intera catena, dall’evento al messaggio, è il tema dell’articolo How Real-Time Is Your Real-Time? Qui considero solo il tempo che il runtime trascorre in attesa di una risposta dal warehouse.
Richieste simultanee, cold start e costi di calcolo
Oltre al tempo di risposta della singola query, conta il numero di richieste simultanee, che spesso diventa il primo limite. I motori analitici le gestiscono mettendole in coda oppure aumentando le risorse di calcolo. La documentazione di Snowflake sui warehouse multi-cluster descrive entrambi i meccanismi: quando le risorse non bastano, le query restano in coda finché non si liberano; in modalità auto-scale il warehouse avvia invece cluster aggiuntivi, ciascuno dei quali consuma crediti finché resta attivo. Durante una promozione o il lancio di un prodotto, però, gli eventi si concentrano in brevi intervalli: se ciascuno richiede un lookup, il warehouse riceve moltissime query su singoli record proprio quando i ritardi pesano di più sul business. Le richieste in coda possono far arrivare la decisione troppo tardi; aumentare le risorse per smaltirle fa invece salire la fattura cloud. Nei warehouse configurati per sospendere le risorse di calcolo durante l’inattività, la prima query deve anche attenderne la riattivazione e, nel caso di Snowflake, viene eseguita senza la cache locale, perché la cache viene eliminata quando il warehouse è sospeso.
La differenza dipende dal modo in cui i dati sono memorizzati. Lo storage a colonne è ottimizzato per aggregare poche colonne su molte righe; lo è meno per restituire rapidamente tutti gli attributi di una singola riga quando arrivano molte richieste simultanee. È il tipo di accesso per cui sono progettati i database operativi key-value o con storage a righe. Il compromesso è documentato da tempo: nel 2008 Abadi, Madden e Hachem hanno mostrato che sui carichi di lavoro tipici dei data warehouse lo storage a colonne supera quello a righe di oltre un ordine di grandezza, e hanno individuato il suo punto debole nel costo di ricomporre le righe complete, cioè proprio ciò che serve a un lookup sul singolo cliente. Google applica la stessa distinzione ai propri prodotti: Bigtable per servire i dati alle applicazioni, BigQuery per le analisi. Per questo le piattaforme di engagement mantengono un proprio profilo operativo e richiedono di sincronizzarvi gli attributi: quel database, vicino al runtime, permette di valutare le regole al momento dell’invio anche sotto carico. La documentazione di Braze distingue le due modalità: il Cloud Data Ingestion standard copia i dati del warehouse sui profili Braze a intervalli pianificati, di default ogni 15 minuti, mentre i CDI Segments lasciano i dati nel warehouse e ne riflettono lo stato all’ultimo aggiornamento. Sul fronte delle CDP, la Federated Audience Composition di Adobe non conserva una copia fisica dei dati e aggiorna le audience con la frequenza impostata in ciascuna composizione. In entrambi i casi l’opzione zero-copy serve a calcolare le audience, mentre la copia che resta serve al runtime.
Anche i vendor dei warehouse hanno introdotto prodotti dedicati a queste esigenze. Nel novembre 2024 Snowflake ha reso disponibili le Hybrid Tables su AWS, descrivendole come tabelle per operazioni su singoli record, con molte richieste simultanee e latenze nell’ordine delle decine di millisecondi, destinate a usi come la gestione dello stato e il data serving. Nel giugno 2025 Databricks ha lanciato Lakebase, un servizio Postgres gestito per applicazioni e agenti, poi reso disponibile su AWS nel febbraio 2026, con tabelle sincronizzate per mantenere allineati i dati operativi e quelli del lakehouse. Entrambi affiancano alle tabelle analitiche un livello operativo per l’accesso ai singoli record a runtime. La scelta architetturale riguarda quindi dove collocarlo: nella piattaforma dati, nella piattaforma di engagement o in un sistema intermedio.
L’architettura della governed hydration
Per contenere latenza e costi senza replicare l’intero patrimonio di dati in una CDP, si può sincronizzare solo ciò che serve alle decisioni a runtime, mantenendo nel warehouse il controllo su quei dati. È il pattern che chiamo governed hydration.
Il warehouse o il lakehouse resta il sistema di riferimento per i dati cliente: gestisce la risoluzione dell’identità, le metriche aggregate, il lifetime value, gli score predittivi e lo storico delle transazioni, senza che i sistemi a valle ne ricalcolino le definizioni. Al runtime di engagement arriva un insieme ristretto di attributi, scelti esplicitamente perché necessari a personalizzare i messaggi, verificare i requisiti di accesso alle offerte, controllare la frequenza degli invii e scegliere il canale. Questi attributi vengono sincronizzati in un database operativo vicino al runtime e aggiornati tramite change data capture (CDC) o sincronizzazioni mirate. Le synced tables di Databricks mostrano le opzioni concrete: una copia una tantum, aggiornamenti pianificati o attivati su richiesta, oppure uno streaming continuo che porta le modifiche in Lakebase in pochi secondi, con il costo più alto.
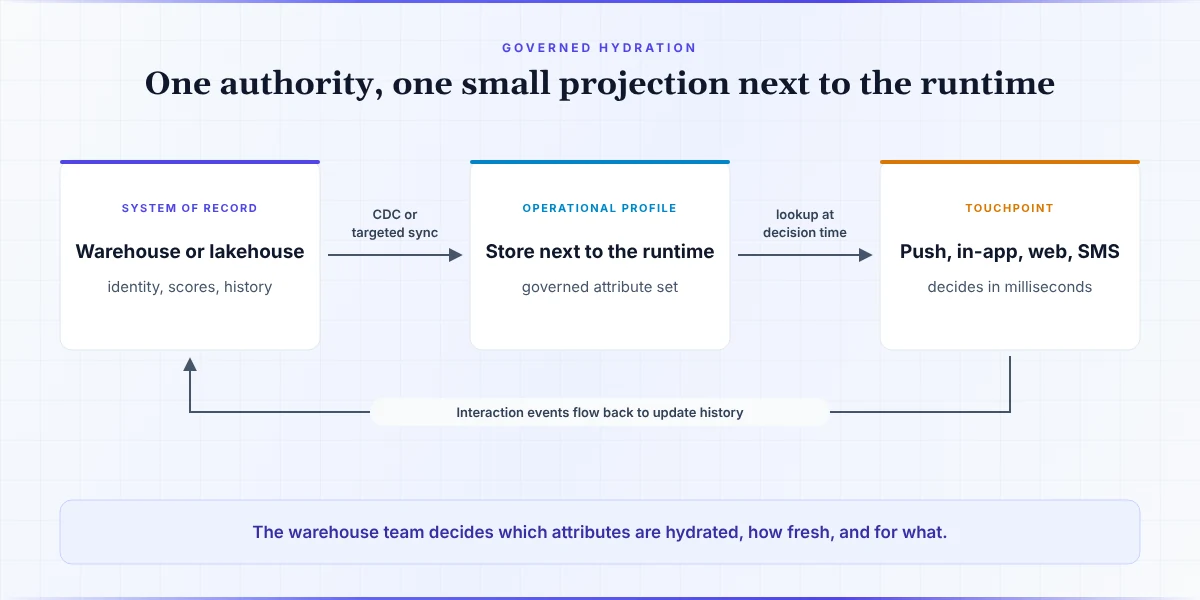
Figura 2. Governed hydration: il warehouse resta il sistema di riferimento e il runtime legge un sottoinsieme dei dati, sincronizzato secondo regole esplicite.
Quando il cliente interagisce, il motore di engagement legge dal database operativo e decide senza interrogare il warehouse; gli eventi prodotti dall’interazione tornano poi nel warehouse ad aggiornare lo storico. Il team responsabile del warehouse stabilisce quali attributi sincronizzare, quanto debbano essere aggiornati e per quali scopi possano essere usati. L’elenco viene versionato come qualsiasi altra interfaccia, così il runtime conserva un sottoinsieme controllato dei dati cliente, senza introdurne una definizione autonoma.
Quel livello operativo può essere il profilo della CEP, una Hybrid Table, un’istanza Lakebase o una cache gestita dall’azienda. La scelta dipende dallo stack e dai pattern architetturali CDP-CEP adottati, e può risentire anche dei cambiamenti tra i vendor: un’azienda che oggi alimenta il profilo Braze dal proprio warehouse potrebbe ricevere pressioni per passare da Data 360 dopo la chiusura dell’acquisizione da parte di Salesforce. È il problema che ho posto in Salesforce compra Braze: cosa cambia per il vostro stack.
Il verdetto
Lo zero-copy migliora la governance, la definizione delle audience e il reporting, ma estenderlo a ogni decisione a runtime significa chiedere ai motori analitici un lavoro per cui non sono ottimizzati. I warehouse aggregano molte righe in secondi o minuti; i runtime di engagement devono rispondere sul singolo cliente in millisecondi. I prodotti sviluppati su entrambi i fronti riflettono questa differenza.
Ogni copia deve avere uno scopo preciso: vicino al runtime bastano i dati necessari a decidere, aggiornati secondo regole definite nel warehouse.
Fonti
Progettazione dei database
- Daniel J. Abadi, Samuel R. Madden e Nabil Hachem, Column-Stores vs. Row-Stores: How Different Are They Really?, SIGMOD 2008.
- Google Cloud, Bigtable vs. BigQuery: What’s the difference?, 20 aprile 2021.
Comportamento dei warehouse con richieste simultanee
- Documentazione Snowflake, Multi-cluster warehouses.
- Documentazione Snowflake, Optimizing the warehouse cache.
Livelli operativi delle piattaforme dati
- Snowflake, Snowflake’s Unistore Unifies Transactional and Analytical Data with the General Availability of Hybrid Tables, 12 novembre 2024.
- Databricks, Databricks Launches Lakebase: a New Class of Operational Database for AI Apps and Agents, 11 giugno 2025.
- Databricks, Databricks Lakebase is now Generally Available, 3 febbraio 2026.
- Documentazione Databricks, Serve lakehouse data with synced tables.
Piattaforme di engagement e CDP
- Documentazione Braze, Compare persistent and zero-copy data ingestion options.
- Adobe Experience League, Federated Audience Composition: frequently asked questions.