Questo articolo è una traduzione assistita dall’AI dell’originale in inglese, revisionata dall’autore.
TL;DR: Un prompt che ha funzionato una volta non è un flusso di lavoro. Su questo sito il lavoro editoriale ricorrente è diventato procedure con un nome, che si portano dietro i propri limiti, un ordine delle operazioni e dei rifiuti, e quel passaggio ha fatto per la coerenza dell’output più di qualsiasi miglioramento del modello sottostante. Il paragone con la journey orchestration è utile in fase di progetto e fuorviante a runtime, e vale la pena essere precisi su quale dei due.
In un workshop, con le persone giuste in sala e una scadenza che chiude venerdì, quasi ogni team riesce a produrre un brief di campagna davvero buono, una definizione di segmento pulita, un journey che riflette il comportamento reale dei clienti. Il problema non è mai stato il primo. È il quarantesimo, prodotto quattro mesi dopo da qualcuno che non era in sala, sotto pressione di tempo e soprattutto quando chi sapeva perché quelle regole esistevano è passato a un altro cliente.
Il tooling agentico lo riproduce su scala più piccola e con un orologio più veloce. Il primo articolo prodotto con un prompt costruito bene era buono. Il quinto era buono in un modo leggermente diverso. Il dodicesimo aveva accumulato una deriva sufficiente perché un lettore della serie la notasse, ed il lettore in questione ero io.
I primi due articoli della serie hanno raccontato di cosa è fatto davvero un sistema agentico e come fallisce in silenzio. Questo parla del livello che sta fra i due: l’insieme di procedure con un nome che trasformano una serie di intenzioni in qualcosa che uno sconosciuto, compresa una versione futura del sistema senza memoria di oggi, può eseguire allo stesso modo.
La terza volta che scrivi le stesse istruzioni
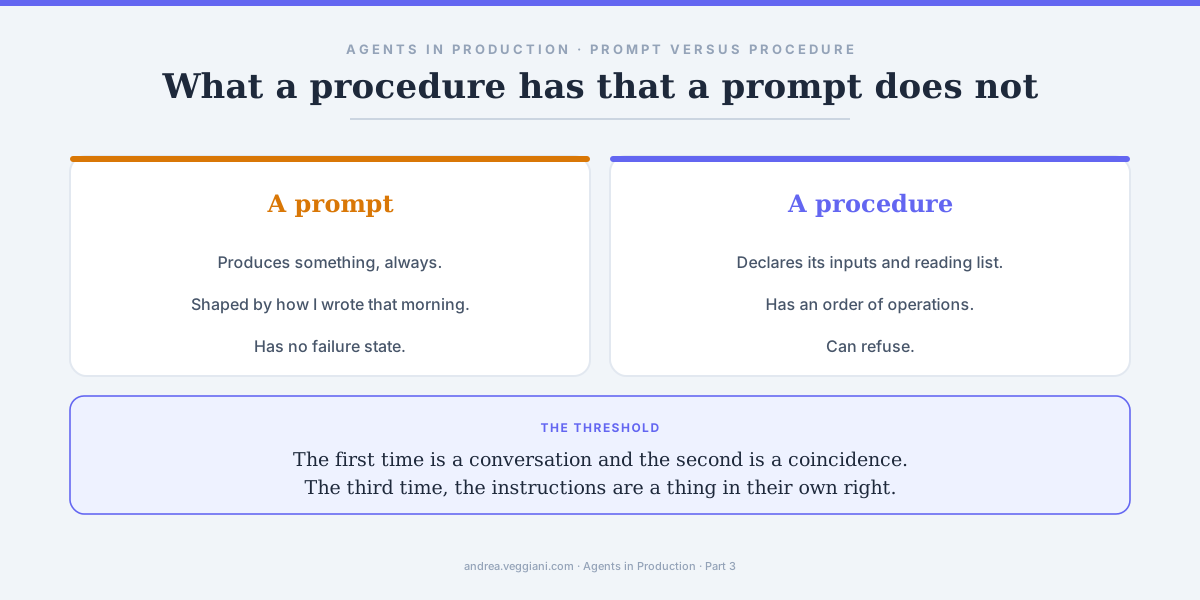
La prima volta che spiego come si costruisce un’uscita settimanale è una conversazione. La seconda è una coincidenza. La terza, le istruzioni sono una cosa a sé e devono stare in un file invece che nella mia tastiera.
Una procedura dichiara i suoi input, quindi è chiaro su quale file opera. Dichiara cosa leggere prima di partire, che su questo sito vuol dire il file della biografia, le regole di scrittura e l’ultima uscita pubblicata come modello strutturale, più un paio di grafiche recenti perché il sistema visivo resti coerente.
Dice quali domande fare all’operatore e, cosa più importante, quali dedurre invece di chiedere, così la sessione non si apre con sei chiarimenti a cui ho già risposto nove volte. Ha un ordine delle operazioni. E ha condizioni alle quali si ferma.
Quest’ultima proprietà è quella che ho impiegato più tempo ad apprezzare. Un prompt non ha uno stato di fallimento. Produce qualcosa, sempre, e quel qualcosa prende la forma di come mi è capitato di scrivere quella mattina. Una procedura può rifiutare.
L’ordine delle operazioni decide la qualità
La procedura di Weekly MarTech Signals comincia dal limite di lunghezza, e comincia da lì per una ragione che vale ben oltre l’editoria.
La serie si era assestata intorno alle 2.030 parole di corpo su tredici settimane consecutive, che era la dimensione giusta per quello che fa. Poi la Parte 14 è arrivata a 3.347 parole e la Parte 15 a 4.345 prima di essere ritagliata. Nelle istruzioni non era cambiato niente. La deriva era graduale, invisibile di settimana in settimana e ovvia su un trimestre, che è poi come si comporta ogni problema di perimetro che abbia visto in un progetto con un cliente.
La mia prima ipotesi era che le sezioni si fossero allungate e che un tetto sulle parole per sezione avrebbe risolto. I dati dicevano il contrario. La sezione più lunga della Parte 14 arrivava a 343 parole, più corta che in ogni uscita precedente tranne una, e l’articolo era comunque raddoppiato, perché aveva undici sezioni dove un’uscita assestata ne ha cinque o sei. Il numero di sezioni era la variabile che guidava tutto, e le parole per sezione erano un numero derivato che oscillava innocuamente fra 260 e 410 da mesi.
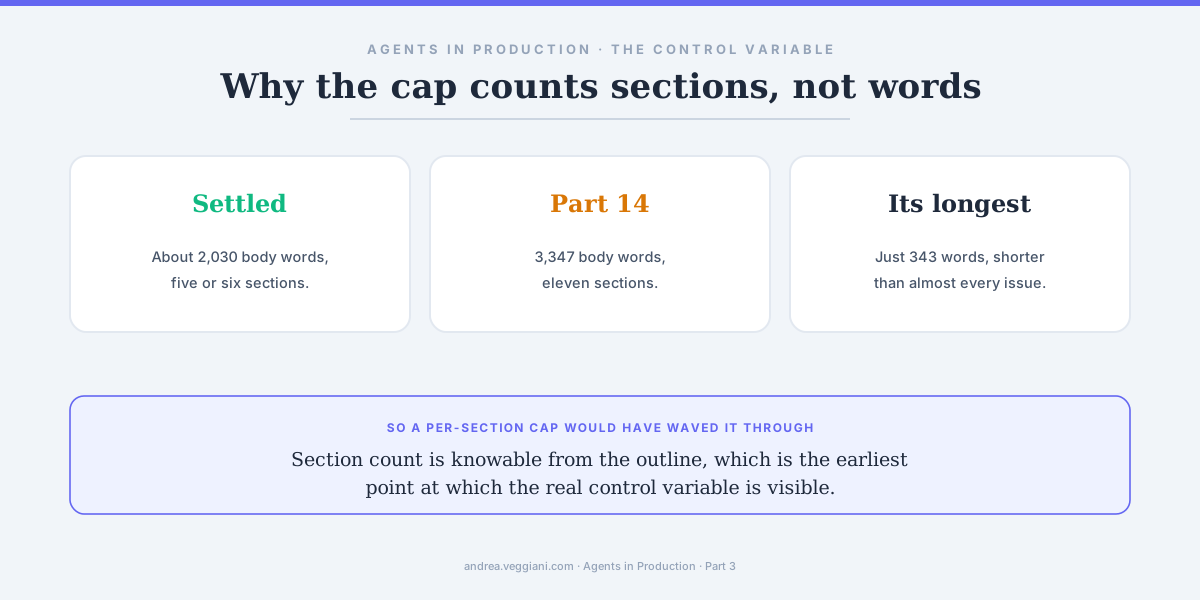
Quindi il limite è di otto sezioni H2 come tetto rigido e 3.000 parole di corpo come secondo tetto rigido, con un obiettivo intorno a 2.400 e una deroga esplicita perché una sezione di apertura possa essere più lunga, dato che ogni buona uscita della serie ha una sezione che porta l’argomento principale della settimana circondata da altre più corte. Un tetto piatto per sezione avrebbe distrutto quella forma senza intercettare il guasto vero.
E il controllo gira sulla scaletta, prima che esista una parola di prosa. Il numero di sezioni è conoscibile in fase di scaletta, che è il segnale più precoce possibile. Un conteggio totale di parole è conoscibile solo alla fine, e imporre un limite alla fine diventa rasare aggettivi da paragrafi finiti, che non è editing e produce un testo che sembra passato sotto un compattatore. Mettere il controllo nel primo punto in cui la variabile è visibile è tutta la decisione di progetto, ed è lo stesso argomento che userei per validare un contratto dati in ingestione invece di riconciliare nel livello di reporting.
La regola di misurazione è altrettanto necessaria: togliere il markdown prima di contare, perché un conteggio ingenuo sopravvaluta questi articoli del sette o otto percento solo sul testo alternativo delle immagini e sugli URL delle fonti. Un controllo che misura il numero sbagliato non è un controllo.
I limiti numerici battono gli aggettivi
«Scrivi in modo conciso» non è un controllo. È una speranza, e verrà interpretata in modo diverso dallo stesso sistema in due martedì consecutivi a seconda di come si presentava il materiale di partenza. «Massimo otto sezioni H2, Fonti escluse» è un controllo. È verificabile e non si degrada quando sono stanco.
Il caso più chiaro su questo sito sono le infografiche. A luglio ho respinto un set intero perché era, nelle mie parole di allora, davvero troppo. La grafica respinta che spiegava il perimetro del protocollo aveva 56 elementi di testo e 293 parole su una sola immagine, che non è un grafico quanto piuttosto una seconda lettura dell’articolo resa in riquadri. La ricostruzione accettata ne aveva 24 e 103 parole. Quei due numeri sono diventati la calibrazione, e ne è uscito un tetto rigido di 27 elementi di testo e 195 parole, con un obiettivo fra 16 e 24 elementi e fra 90 e 120 parole, più limiti strutturali precisi: un occhiello e un titolo, da due a quattro schede di contenuto, nessun riquadro annidato dentro le schede, esattamente un richiamo di chiusura.
Ognuno di questi è un numero o un conteggio. Nessuno è un giudizio che devo riformare ogni settimana. E in quella regola c’è un dettaglio che mi piace più della regola stessa: quando una grafica viene sfoltita va sfoltito anche il testo alternativo, perché l’alt fa da didascalia visibile in queste serie e descrivere elementi che non sono più sulla tela è una piccola bugia per conto suo. Le immagini di apertura sono del tutto esentate dal tetto, perché una copertina fa un lavoro diverso.
È la forma di ogni buon vincolo che ho scritto qui. Un numero, un perimetro e un’esenzione esplicita perché nessuno debba indovinare.
Il progetto sta nei rifiuti
Chi legge queste procedure per quello che automatizzano si porta a casa un’immagine fuorviante: quasi tutte le decisioni di progetto che contengono riguardano quello che è loro vietato fare.
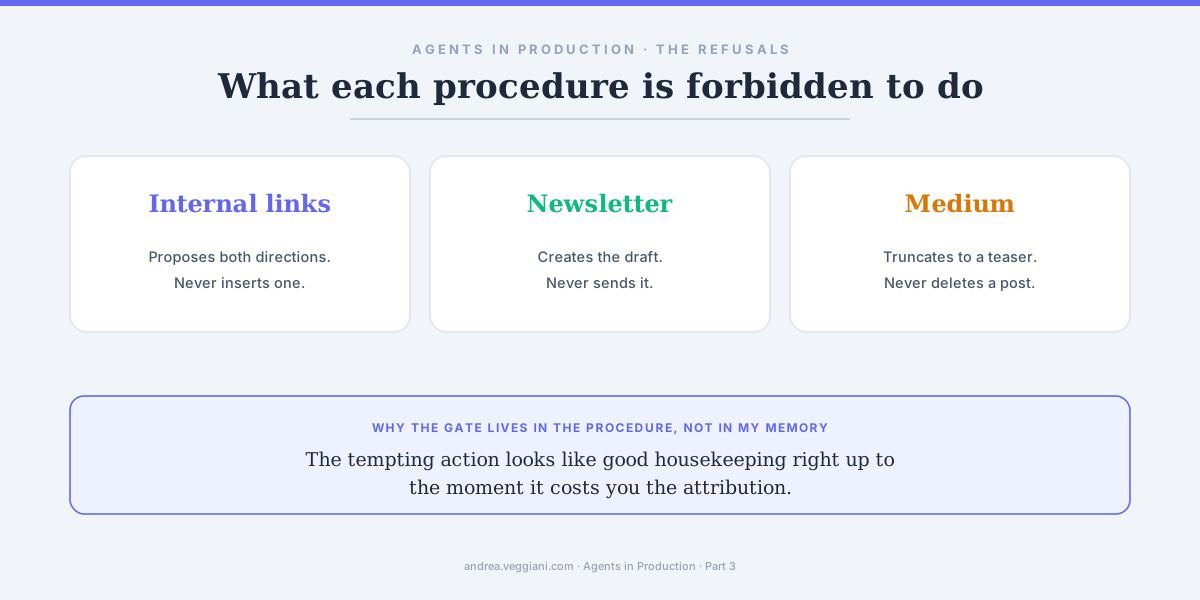
La procedura di linking interno scansiona il corpus e propone link nelle due direzioni, quelli che un nuovo articolo dovrebbe portare e quelli con cui gli articoli esistenti dovrebbero puntargli indietro, e poi si ferma. Non inserisce mai niente. Ogni proposta viene approvata singolarmente, perché i link interni reggono il modo in cui il sito viene capito sia dai lettori sia dai crawler, e un link plausibile fra due articoli che non parlano davvero della stessa cosa è peggio di nessun link. Porta anche una regola per cui gli articoli italiani rimandano solo ad articoli italiani, che sembra ovvia finché non si vede un sistema collegare premurosamente un lettore italiano a una destinazione in inglese.
La procedura della newsletter crea una bozza e solo una bozza. Invio e programmazione richiedono che lo dica esplicitamente e confermi data e ora, e i default dello script rendono il percorso sicuro. È voluto, perché un’impostazione di default che richiede vigilanza non protegge nessuno.
La procedura di Medium ha due rifiuti dentro. Pubblica un teaser troncato con il canonical che punta a casa e mai il testo completo, che è una decisione di posizionamento: non competere con il mio stesso sito sui miei stessi titoli. E non cancella mai un post su Medium in nessuna circostanza, perché il tag canonical su quei post è al momento ciò che dice a Google quale versione è l’originale, e cancellare il post distrugge quel segnale. Troncare, sempre. Quella regola sta scritta nella procedura invece che nella mia testa perché l’azione allettante, ripulire un vecchio duplicato, sembra buona manutenzione fino al momento esatto in cui costa l’attribuzione.
Ognuno di questi gate rende il sistema un po’ meno capace e parecchio più installabile, che è uno scambio che i compratori enterprise stanno riscoprendo a ogni ciclo di offerta agentica di quest’anno. Una versione di questo argomento, su dove il giudizio umano restava insostituibile, l’ho fatta nel secondo articolo sul lavoro di demo con Braze, e i mesi di uso continuo da allora hanno solo reso più netta la linea che traccerei.
Dove regge il paragone con la journey orchestration, e dove smette
Viene voglia di descrivere tutto questo come journey orchestration applicata al lavoro editoriale, e c’è abbastanza verità in quella descrizione da renderla pericolosa.
Le parti che corrispondono davvero sono parti di progettazione. Dare un nome a un’unità di lavoro riusabile invece di ricostruirla ogni volta è lo stesso istinto che produce un template di canvas invece di quaranta journey costruiti a mano. Dichiarare gli input che un’unità si aspetta è la stessa disciplina del definire eventi e attributi da cui un journey dipende, e salta nello stesso modo quando la si salta. Mettere il gate di approvazione dentro l’artefatto, così che viaggi con la cosa invece di vivere nella memoria di chi l’ha costruita, è esattamente quello che un template di journey ben progettato fa con i suoi criteri di uscita e i suoi frequency cap. E versionare la procedura perché una modifica sia visibile è la stessa ragione per cui nessuno sano di mente modifica un canvas vivo in produzione.
Le parti che non corrispondono sono tutte le parti di runtime, e sono quelle difficili.
Un journey gira in concorrenza su milioni di profili, con stato per profilo, race condition, finestre temporali e la possibilità costante che la stessa persona si qualifichi per tre cose insieme. Le mie procedure girano una volta, in sequenza, per un operatore solo, su un file solo. Un journey ha una proprietà distribuita su più team, che sposta il lavoro vero nella negoziazione fra brand, CRM, legale e chi possiede il contratto dati. Le mie regole non le ho negoziate con nessuno. Un journey porta esposizione normativa attraverso consenso, preferenze e retention, mentre il mio esito peggiore è una frase da correggere dopo la pubblicazione. E un journey si misura su risultati che arrivano settimane dopo attraverso un modello di attribuzione di cui tutti in sala diffidano, mentre il mio ciclo di feedback sono io che rileggo la cosa il venerdì.
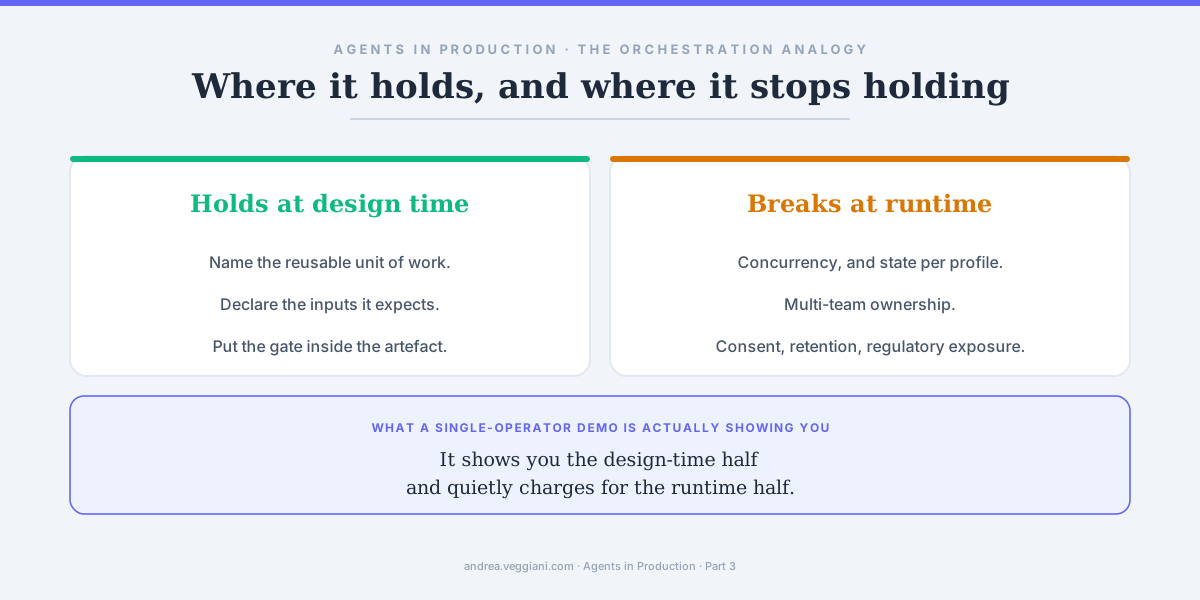
Quindi la posizione onesta è che questo è un buon paragone per come strutturare il lavoro di un agente e un cattivo paragone per stimare quanto sarà difficile la versione enterprise. Chi vende orchestrazione agentica sulla forza di una demo a operatore singolo vi sta mostrando la metà di progettazione e vi sta facendo pagare in silenzio la metà di runtime.
Cosa sopravvive a un cambio di modello
Il che mi riporta all’argomento che sostengo sulle piattaforme da venticinque anni, e che costruire questa macchina ha messo alla prova su qualcosa che possiedo.
Tutto quello descritto in questi tre articoli è scritto in formati che sopravvivono al loro tooling. I file di contesto sono markdown. Il controllo di integrità è qualche centinaio di righe di Node che qualsiasi runtime può eseguire. Le procedure sono prosa con un ordine delle operazioni dichiarato e una serie di numeri. La memoria è una cartella di piccoli file di testo con un indice. Se il modello sotto cambiasse domani, o il tooling intorno, il substrato andrebbe ricollegato e niente di tutto ciò andrebbe riscritto, dato che niente di tutto ciò codifica qualcosa del modello.
È la stessa affermazione che faccio quando un cliente mi chiede di confrontare due customer engagement platform e io passo la prima ora a parlare del loro modello di identità. Il livello del vendor è la parte che cambia. Il livello che decide se la cosa funziona al quinto mese è quello che descrive cosa state facendo, in che ordine, con quali limiti e dove avete deciso che la macchina deve fermarsi a chiedere.
Le piattaforme vanno e vengono. L’architettura vince, e si scopre che vince anche a questa scala, su un sito personale con un pubblico che starebbe in una sala riunioni.
C’è un soffitto sopra tutto questo, e tutti e tre questi articoli ci hanno sbattuto nello stesso punto. Niente di quello che ho descritto qui è stato negoziato con qualcuno. Un operatore solo, un workspace solo, un insieme di regole che non ha mai dovuto sopravvivere a un disaccordo, e in qualsiasi organizzazione quella negoziazione è il lavoro. Quando una seconda persona può far partire la stessa procedura si apre una serie diversa di domande: come chi sta agendo l’agente, cosa gli è permesso fare mentre indossa quell’identità, quale policy vince quando due entrano in conflitto?, e come si ricostruisce dopo cosa ha fatto e su quale autorità. Nessuna di queste esiste alla scala di una persona sola, ed è esattamente per questo che la serie si ferma qui. Sono il tema della prossima.
Fonti
Anthropic
- Introducing Claude Skills. Il formato di istruzioni impacchettate in cui sono scritte le procedure descritte qui.
Documentazione di piattaforma
- Medium, API documentation repository. Archiviato, ed è il motivo per cui la procedura di cross-posting passa da una sessione browser invece che da un’integrazione.