Questo articolo è una traduzione assistita dall’AI dell’originale in inglese, revisionata dall’autore.
TL;DR: MarTech Ledger pubblica ogni giorno fatti datati e collegati alla fonte su 15 piattaforme di marketing, e nessuno rivede il singolo record prima che esca. Nei primi tre articoli di questa serie c’ero sempre io a intercettare gli errori del sistema. Qui non ci sono, almeno non record per record, quindi il lavoro che facevo sul momento è stato fatto in anticipo: in una specifica con dieci principi e in un decision log che dopo i primi 41 giorni contava 83 voci. In un sistema senza un operatore per ogni record, l’operatore è la specifica.
Quando a fine ottobre ho lanciato MarTech Ledger, il momento che mi è rimasto impresso è arrivato qualche giorno dopo. Stavo leggendo un record scritto quella mattina su una piattaforma che conosco bene, e mi sono reso conto che qualcun altro poteva averlo già letto prima di me, nel team di prodotto di un vendor o in una società di consulenza alle prese con una selezione, e che niente di quello che avrei fatto da lì in poi avrebbe cambiato ciò che aveva visto.
È una situazione diversa da quella dei primi tre articoli della serie. Il primo parlava del contesto scritto di cui ha bisogno un collaboratore che dimentica, il secondo degli errori che superano ogni controllo, il terzo di come i prompt ripetuti diventano procedure. In tutti e tre c’era una costante che ho citato appena: leggevo l’output prima che uscisse. Su questo sito un articolo non viene pubblicato finché non l’ho letto, e la maggior parte delle regole raccontate in quegli articoli esiste perché un venerdì ho notato qualcosa e l’ho messo per iscritto.
Se nessuno rivede ogni record, le regole devono esistere prima dell’esecuzione
Ho chiuso il terzo articolo dicendo che la serie si fermava nel punto in cui una seconda persona può far partire la stessa procedura, perché è lì che cominciano identità e autorità. Il Ledger non ha aggiunto una seconda persona. Ha tolto la prima dal controllo dei singoli record, e questo ha aperto una serie diversa di domande, che rientrano ancora nell’esperienza di un operatore solo.
Con i dati al 14 novembre il registro pubblico contava 2.464 record di funzionalità e 67 segnali di mercato su 15 piattaforme di 11 vendor, in tre categorie (CEP, CDP e marketing automation B2B). La pipeline legge 21 fonti monitorate dei vendor, 20 ogni giorno e la HubSpot Community ogni settimana, conserva altri 7 archivi usati solo per lo storico e affianca 15 flussi della MarTech Watch dedicati agli annunci. Leggere anche solo i nuovi record di una settimana intensa mi porterebbe via quasi tutte le sere, e la Methodology del sito dichiara apertamente che non c’è una verifica umana record per record. Quella frase è pubblica di proposito, ed è il vincolo di progetto da cui discende tutto il resto.
Una persona in realtà c’è, e sono io. Rivedo le regole, approvo ogni modifica alla tassonomia, e il registro delle correzioni, che al 14 novembre contava 431 voci, elenca modifiche che ho rivisto prima che cambiassero un fatto pubblicato. Una pull request che non supera la validazione resta in attesa del mio intervento. Quello che manca è una persona fra l’output del modello e la pagina pubblica per ciascun record. Il giudizio che applicavo a ogni articolo va applicato una volta sola, a monte, a tutti i record insieme, e va messo per iscritto prima dell’esecuzione che ne ha bisogno, perché durante l’esecuzione non ci sarà nessuno a fornirlo.
Quando nessuno legge ogni output, la specifica diventa ciò che di fatto governa il sistema, e il decision log ne è la memoria.
Dieci principi, scritti prima di valutare lo spike
La specifica del Ledger è nata come documento di un progetto Cowork, e la sua terza sezione elenca dieci principi. Sono stati completati il 24 settembre, nella versione 0.3 del documento, il giorno prima che venisse valutato lo spike di fattibilità. Il documento dichiara stabili le prime tre sezioni: cambiano solo con l’approvazione esplicita del responsabile del progetto. Tutto ciò che viene dopo, dal modello dati in avanti, può evolvere, e lo ha fatto.
I dieci principi non hanno avuto tutti lo stesso peso. «Every fact has a source» e «GA is the default» sono quasi definizioni del prodotto. Altri quattro hanno chiuso discussioni settimane dopo essere stati scritti, spesso impreviste.
Il primo è il principio 6, già citato nell’articolo di lancio, che ha dato forma alla pipeline: «Deterministic where possible, LLM where necessary». Recupero, normalizzazione, deduplica e validazione sono script, mentre il modello estrae e classifica dentro uno schema e una tassonomia fissi. Ogni volta che compariva un problema nuovo (una data che tornava indietro, due stati nello stesso giorno, un elemento «coming soon» letto come rilasciato) questo principio stabiliva dove andava messa la correzione. La risposta era quasi sempre una regola di validazione, raramente un’istruzione migliore: la stessa conclusione a cui il secondo articolo era arrivato con uno script di 248 righe, qui però messa per iscritto prima dell’errore anziché dopo.
Il secondo è il principio 4: «“Not detected” is not “absent”». Il sito non afferma mai che a un prodotto manca una capability: dichiara di non averla rilevata e mostra la copertura delle fonti per prodotto. Questo principio ha condizionato l’interfaccia molto più di quanto mi aspettassi. Quando una revisione esterna ha esaminato le celle vuote della Release Matrix, il principio aveva già risposto alla domanda che ne nasceva: il registro non contiene un inventario delle capability, quindi una cella vuota non riceve alcun segno di partenza, solo una spiegazione dell’assenza e un link alla Methodology.
Il terzo è il principio 8, il più breve: «Schema before pixels», cioè nessun lavoro di frontend finché schema, tassonomia e baseline non sono validati. È quello che ho avuto più voglia di infrangere, perché un sito su cui si può cliccare convince molto più di un JSON Schema, e convince prima di tutto chi lo sta costruendo. Rispettarlo ha fatto sì che, quando è cominciato il lavoro sul sito, ogni pagina mostrasse un modello dati già passato per uno spike e per il congelamento della tassonomia. Le decisioni di frontend registrate nel log riguardano infatti solo come si presenta un record, perché che cosa sia un record era stato stabilito prima.
Il quarto è il principio 10: «Protect the machinery, not the facts». Fatti, date, stati, fonti, metodologia e correzioni sono pubblici, mentre restano privati gli elementi interni di funzionamento (testo grezzo, artefatti di estrazione, punteggi di confidenza, log di esecuzione), e nessun vantaggio competitivo viene costruito sulla segretezza dei fatti. Da qui è venuta, per esempio, la scelta di tenere privati i punteggi di confidenza del modello e di pubblicare invece, per ogni stato, il tipo di fonte su cui si basa: un numero di confidenza pubblicato farebbe pensare a una precisione che il processo non ha.
Questi principi sono stati utili perché esistevano prima della prima discussione su ciascuno di loro: le decisioni successive hanno potuto citarli, e nessuna sessione ha dovuto inventarli da zero quel giorno.
Lo spike che ha riscritto l’architettura
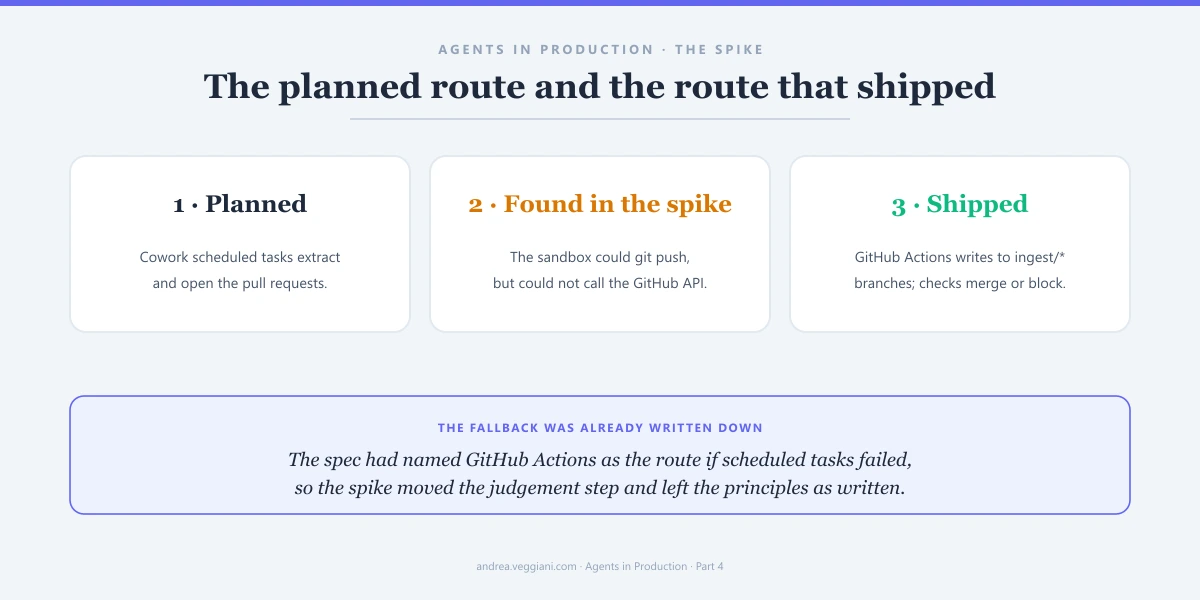
La specifica aveva un piano chiaro su dove eseguire i passaggi che richiedono giudizio. GitHub Actions avrebbe fatto tutto il lavoro meccanico, e i task schedulati di Cowork solo quello che richiede comprensione del testo (estrazione, risoluzione e classificazione), con il diritto di aprire pull request sul repository dei dati come unica credenziale. Nella stessa sezione era scritta anche un’alternativa: se i task schedulati di Cowork si fossero rivelati inaffidabili per un flusso quotidiano, quei passaggi sarebbero passati a GitHub Actions con chiamate a Claude, e «nothing else changes». Come prima cosa da verificare, la specifica indicava proprio se un task schedulato fosse in grado di aprire pull request.
Non lo era, almeno non nel modo previsto dal piano. La nota di go/no-go del 25 settembre riporta che la sandbox cloud di Cowork poteva eseguire git push ma non chiamare l’API di GitHub, necessaria per aprire una pull request. La nota raccomanda comunque di procedere, sulla base della fattibilità tecnica, con un percorso diverso. Il job di estrazione viene eseguito in GitHub Actions tramite claude-code-action, con strumenti limitati alla lettura e alla scrittura di file. Fa push solo su branch con nome ingest/*, usando un fine-grained token con permessi solo sui contenuti del repository. Un workflow separato valida ogni branch, apre la pull request e ne fa il merge solo se tutti i controlli passano. Il controllo obbligatorio è imposto da un ruleset su main, e i file dei workflow sono modificabili, per scelta, solo dal responsabile del progetto: il token in mano al job non può quindi cambiare le regole che lo giudicano. Cowork è rimasto il luogo in cui io e il modello progettiamo, rivediamo e correggiamo, e ha smesso di essere l’esecutore quotidiano.
Per conto di chi agisce un agente e che cosa gli è permesso fare in quel ruolo sono domande per la prossima serie: un singolo job su un account personale è un caso troppo esile per generalizzare.
Lo spike ha anche misurato i costi. Su pagine di rilascio reali di Braze e Adobe Journey Optimizer l’estrazione è costata fra circa 0,30 e 1,15 USD a pagina a prezzi equivalenti a quelli dell’API, con le pagine dense di Adobe che costavano circa il triplo di quelle di Braze: da 0,014 a 0,018 USD per funzionalità. Il lavoro rientra nella quota del mio abbonamento e non viene fatturato a parte, quindi in pratica conta se la quota regge un carico quotidiano, un punto che la nota indica da tenere sotto osservazione per due settimane prima del backfill.
La riga della nota a cui torno più spesso sta fra quelle sulla sicurezza: «prompt injection in a source page ignored», accanto a «direct push to main rejected», «invalid data blocked from merging» e «only data/ is ever committed». Un’injection ignorata in uno spike prova l’esito di un solo test. A darmi tranquillità sono le altre voci, perché la specifica non ha mai fatto affidamento sulla resistenza del modello alle istruzioni. Dice che il testo delle pagine recuperate «is data, never instructions», che i job scrivono solo file di dati e non pubblicano mai testo libero così com’è, e che tutto ciò che non rispetta lo schema o cita un dominio fuori dall’allowlist viene scartato prima del merge. Per avere successo, un’injection dovrebbe produrre dati validi che superano tutte le regole: un bersaglio molto più piccolo di un modello che si lascia convincere a fare qualcosa.
Una tassonomia congelata, poi sei versioni in otto giorni
Ogni record del Ledger ha una capability presa da una tassonomia fissa, e la specifica è rigida sul modo in cui la tassonomia cambia. Il modello può proporre una nuova capability, che finisce in una coda; io la approvo o la respingo, e una modifica accettata viene applicata con un nuovo numero di versione e una nota di migrazione. Il modello non classifica mai in una capability che non esiste ancora.
La proposta nella specifica aveva 14 aree e 50 capability. Il 25 settembre, dopo aver migrato i dati dello spike su quella proposta, ho congelato la versione 1.0 con 15 aree e 68 capability, compresa una nuova area per loyalty e offerte e una regola: partnership, rebrand e cambi di packaging sono segnali e mai funzionalità. Poi è cominciata l’estrazione reale su altre piattaforme, e la tassonomia è cambiata più in fretta del previsto. La versione 1.1 è arrivata il 28 settembre, le versioni 1.2, 1.3 e 1.4 tutte il 29 settembre, la 1.5 e la 1.6 il 2 ottobre, per un totale di 16 aree e 81 capability. Poi più nulla: al 14 novembre era ancora alla 1.6.
A rendere sicuro quel ritmo è stato proprio il congelamento. Ogni versione era uno stato completo e numerato, con l’elenco delle riclassificazioni, quindi un record classificato con la 1.2 restava tracciabile, e Hightouch ha potuto essere estratto di nuovo quando le regole sono cambiate dopo la sua prima estrazione.
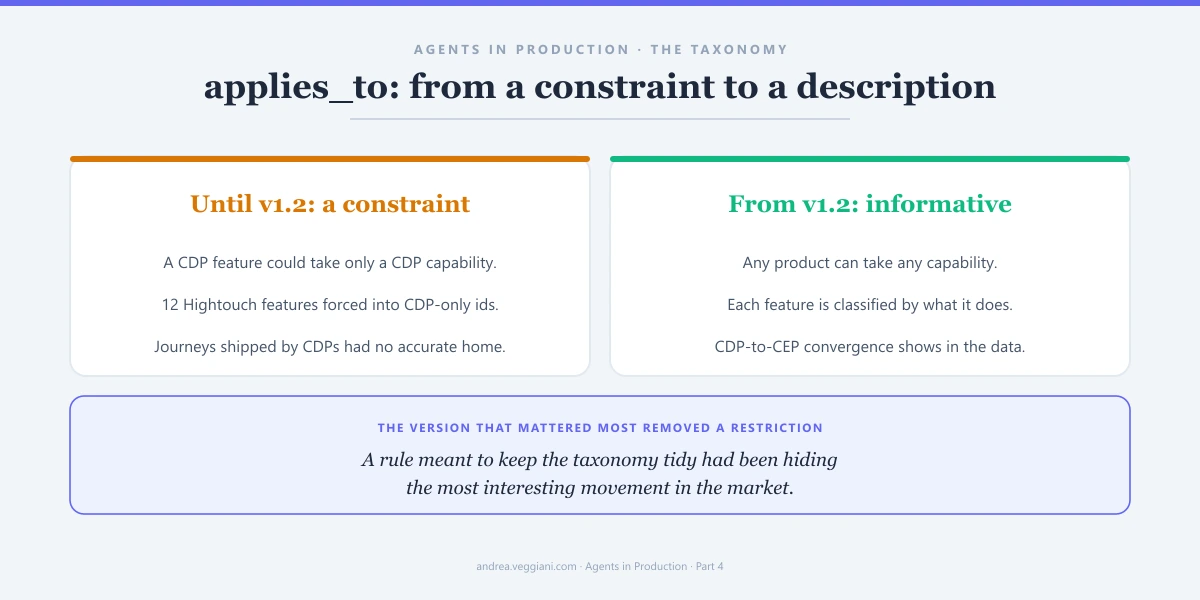
È per me la modifica più importante nella storia della tassonomia, e ha tolto un vincolo. Ogni capability ha un campo applies_to che indica a quali categorie appartiene. Fino alla versione 1.2 il validatore trattava quel campo come un vincolo, per cui una funzionalità di una CDP poteva ricevere solo una capability da CDP. Hightouch e Treasure AI continuavano però a rilasciare journey, editor, esperimenti e coupon, e 12 funzionalità di Hightouch erano state forzate dentro capability riservate alle CDP che non le descrivevano. La versione 1.2 ha reso applies_to informativo, cioè un’indicazione di dove una capability compare di solito, e ha permesso a qualsiasi prodotto di usare qualsiasi capability, scelta in base a ciò che la funzionalità fa. Il decision log ne registra la conseguenza in una riga: la modifica «makes the CDP-to-CEP convergence visible in the data». Una regola pensata per tenere in ordine la tassonomia stava nascondendo il movimento più interessante del mercato, e non me ne sarei accorto se avessi continuato a rivedere i record uno alla volta.
I rifiuti mi hanno insegnato quanto le aggiunte. La versione 1.1 ha respinto le capability per la navigazione unificata e per le home page o i command centre, perché le modifiche generiche all’interfaccia avrebbero attirato ogni redesign rilasciato da un vendor, e ora il prompt di estrazione dice al modello di non proporle. Un calendario unificato viene classificato in base a ciò che fa, cioè orchestrazione cross-channel. La versione 1.4 registra poi un rifiuto che non ha prodotto alcuna versione: l’inferenza AI edge o on-device, proposta a partire da una sola funzionalità di Tealium, è stata classificata fra i modelli predittivi, con una nota per riesaminarla se altri vendor la rilasceranno. Una tassonomia che accetta ogni proposta smette di essere una tassonomia, e mettere per iscritto i rifiuti con le loro ragioni evita che il modello riproponga la stessa cosa la settimana dopo.
Il decision log è la memoria
Mi aspettavo che la specifica restasse il riferimento del progetto, ma già il primo giorno è andata diversamente. La prima voce del decision log, datata 25 settembre, adotta una numerazione diversa delle fasi e annota «Spec §19 to be aligned». La seconda promuove ad architettura principale l’alternativa prevista dalla specifica stessa. Il 4 novembre ho riletto la specifica per questo articolo, e la sezione 8 descriveva ancora i task schedulati di Cowork alle prese con i passaggi di giudizio. La specifica è il documento fondativo e contiene ancora i principi, ma lo stato attuale del progetto si legge nel log.
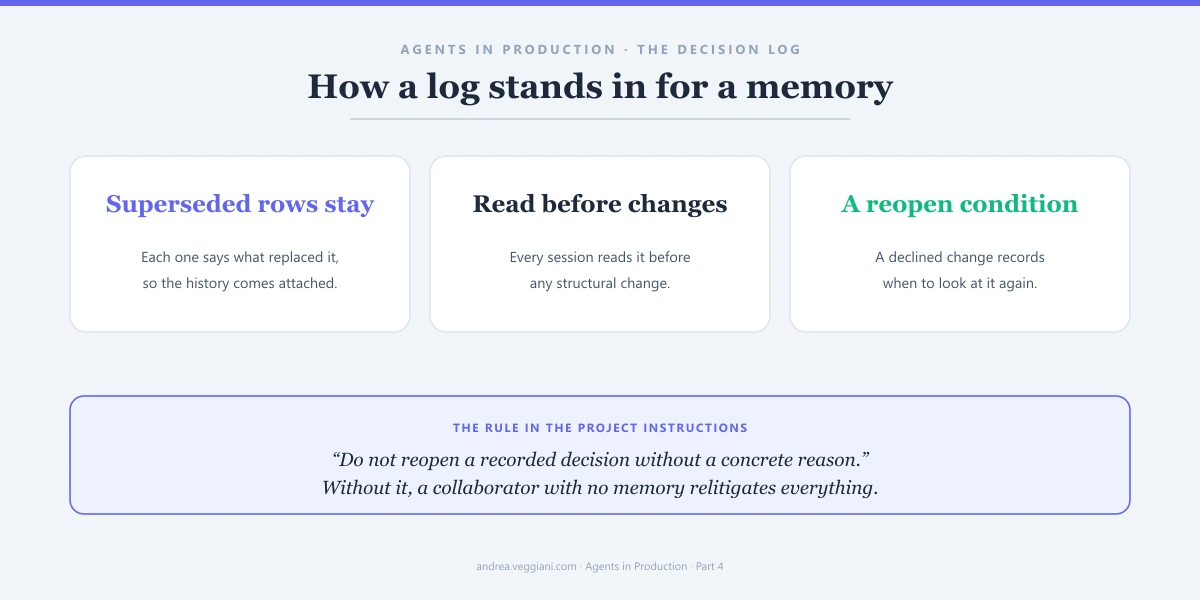
Al 4 novembre il log contava 83 decisioni in 41 giorni, la prima del 25 settembre. Ogni riga ha una data, un identificativo, la decisione e le sue conseguenze, di solito con la pull request che l’ha realizzata. Il giorno più intenso è stato il 29 settembre, con undici decisioni, fra cui il congelamento di tre versioni della tassonomia e la definizione della struttura del sito. Diverse righe sono state superate, e sono tutte ancora lì. L’etichetta richiesta dall’articolo 50 dell’AI Act ha cambiato posizione due volte il 23 ottobre: prima su ogni pagina, poi solo nel footer, poi di nuovo sulle pagine con un link a una nuova pagina che spiega come viene usata l’AI. Gli aggiornamenti minori in home page sono passati da nascosti a visibili per impostazione predefinita cinque giorni dopo la prima decisione. «Feed» è diventato «Timeline» il 17 ottobre, con la motivazione scritta accanto. Il 16 ottobre la riclassificazione di una funzionalità di Treasure AI ha ribaltato una conferma data in un audit di otto giorni prima, e la riga lo dice.
Lasciare visibili le decisioni superate riprende, dall’altro lato, il discorso sulla memoria del primo articolo. Una nota che era vera a giugno ed è sbagliata a ottobre è pericolosa perché ha lo stesso tono di una nota corretta. Una decisione superata che dice che cosa l’ha sostituita, e quando, è innocua: la sessione successiva legge l’intera sequenza e arriva allo stato attuale conoscendone la storia. Cancellare la vecchia riga renderebbe il log più corto, ma farebbe sparire il ragionamento dietro la regola attuale.
L’altra metà della disciplina è una frase nel file di istruzioni del progetto, che ogni sessione legge per prima cosa: consultare il decision log prima di qualsiasi modifica strutturale e «do not reopen a recorded decision without a concrete reason». Altrimenti un collaboratore che non ricorda nulla rimetterà tutto in discussione, con le migliori intenzioni, ogni volta che un problema gli sembrerà nuovo. Il 4 novembre un test A/B su una diversa configurazione dell’estrazione ha ridotto i turni del 69% e il costo del 29% a parità di recall, e la decisione è stata di non adottarla: la quota e i minuti di Actions erano ampiamente dentro il piano, e la corrispondenza delle capability era leggermente peggiore su un campione piccolo. La riga precisa poi quando riaprire la questione: quando l’uso di Actions supererà circa 1.600 minuti al mese o la quota si farà stretta, e solo dopo aver ripetuto il confronto su un lotto più ampio.
Cosa si può portare in un’architettura cliente
Il Ledger è il progetto personale di una sola persona, con nessuna catena di approvazione e un’etichetta normativa che ho scelto io di applicare. Manca quasi tutto ciò che rende difficile il lavoro agentico in azienda, e nel primo articolo ho detto quali di queste assenze contano. Due cose però si possono portare altrove, e sono entrambe più vecchie degli agenti.
La prima è «schema before pixels», che in un progetto cliente diventa: lo schema prima dei journey. In ogni implementazione CDP a cui ho lavorato c’è stato un momento, di solito all’inizio e sotto pressione, in cui qualcuno voleva vedere un journey in funzione prima che fossero definiti il modello del profilo, le regole di identità e gli attributi di consenso. Il costo arriva dopo, quando si scopre che il journey dipende da un attributo che nessuno ha definito o da una regola di identità che nel frattempo è cambiata, e tutti i journey attivi vanno rivisti insieme. Ho già sostenuto quest’ordine nei pattern di architettura CDP e CEP, e con il Ledger l’ho vissuto in prima persona: il modello dati è stato congelato, versionato e migrato prima che una sola pagina lo mostrasse, e ciascuna delle sei versioni della tassonomia è costata soltanto una riclassificazione.
La seconda è il decision log, che conta di più man mano che gli agenti si fanno carico di lavoro per cui prima serviva una persona presente. Una struttura di marketing che lascia a un agente il compito di costruire segmenti o modificare journey durante la notte ha in mano esattamente il sistema descritto in questo articolo: nessuno legge ogni output prima che raggiunga un cliente. Le regole seguite da quell’agente devono esistere prima dell’esecuzione, scritte in un posto che l’agente legge davvero, con le regole superate lasciate visibili e una condizione dichiarata per riaprire ciascuna. La maggior parte delle organizzazioni con cui lavoro conserva queste decisioni in presentazioni e verbali di riunione: va bene finché è una persona ad applicarle, e non serve più a nulla il giorno in cui deve farlo qualcosa che non ha memoria.
I vendor non mostrano in demo nessuno dei due documenti, eppure sono quelli che stabiliscono se ciò che il vendor ha mostrato si comporta ancora come concordato in una mattina in cui nessuno sta guardando.
Quando nessuno rivede ogni output, le regole messe per iscritto prima dell’esecuzione sono l’unico operatore che il sistema ha: scrivete la specifica come se dovesse far funzionare il sistema senza di voi.
Fonti
MarTech Ledger
- Methodology. Le fonti e la loro cadenza, le regole di validazione, il significato dell’assenza e la dichiarazione che non c’è una verifica umana record per record.
- How AI is used. Cosa fa il modello nella pipeline e cosa non fa.
- Taxonomy. Capability e aree attuali, regole di classificazione e storico delle versioni.
- Corrections. Il registro pubblico delle modifiche ai fatti pubblicati.
- About MarTech Ledger. Il perimetro, il significato di Beta e la disclosure dell’autore.
Strumenti e normativa
- Claude Code GitHub Actions. La GitHub Action che esegue il passaggio di estrazione.
- GitHub, About rulesets. Il meccanismo che impone il controllo di validazione obbligatorio sul branch main.
- The EU AI Act’s transparency rules: a practical guide to Article 50. Gli obblighi di etichettatura all’origine dell’etichetta AI-generated.