Questo articolo è una traduzione assistita dall’AI dell’originale in inglese, revisionata dall’autore.
Primo di tre articoli sulla costruzione della mia video factory: il primo pilota, le scelte tecnologiche e il lavoro necessario perché narrazione e diagrammi valessero la visione.
Il primo video completo del mio articolo sulla CDP aveva le dimensioni giuste, una traccia audio con una versione riconoscibile della mia voce e abbastanza elementi in movimento da passare per una spiegazione animata, e sono stato costretto a scartarlo. Anche la versione successiva, con 95 momenti visivi allineati alla narrazione (il che in un report di produzione suona come un bel passo avanti), è stata scartata.
Entrambi i file si riproducevano senza problemi, eppure nessuno dei due spiegava l’architettura abbastanza bene a chi non avesse letto l’articolo.
È da qui che il progetto diventa interessante, perché trasformare un articolo in video richiedeva diversi tipi di lavoro e generare il file ne risolveva uno solo. La factory è diventata utile quando abbiamo saputo definire una buona spiegazione in modo abbastanza chiaro da poterla riprodurre.
Cosa volevo costruire dopo il sito
Il sito è nato a marzo come luogo dove pubblicare i miei articoli e per tornare a costruire; da allora ho scritto di cosa è cambiato quando gli assistenti AI hanno iniziato a produrre artefatti funzionanti e di come far funzionare quella collaborazione da un mese all’altro. Ad agosto avevo una serie di articoli di architettura i cui argomenti stavano già insieme, e volevo portarli in video senza mettere in piedi una seconda redazione.
The Architecture Behind the Acronyms era il punto di partenza naturale. Questi articoli spiegano quale problema risolveva in origine una categoria, come si sono spostati i suoi confini e quale requisito architetturale sopravvive quando l’etichetta diventa ambigua: flussi di dati e confini di responsabilità che un diagramma può mostrare, e cambiamenti che il movimento può rendere più facili da seguire.
Siamo partiti dall’articolo sulla CDP, il cui video finito è pubblico su YouTube (in inglese), e abbiamo proseguito con DMP e CEP. In questo articolo «noi» indica tre soggetti: io ho dato la direzione editoriale e preso ogni decisione di approvazione, mentre Codex e Claude Cowork hanno trasformato quelle decisioni in script, codice e file di produzione. Come ha retto questa divisione del lavoro è il tema del secondo articolo, perché il primo problema era decidere cosa chiedere loro di produrre.
Prima del video serve un nuovo script
L’articolo sulla CDP sostiene che un profilo cliente affidabile resta necessario anche quando cambia la sua collocazione fisica: una piattaforma pacchettizzata, un’architettura centrata sul warehouse e una suite di engagement possono rivendicarne ciascuna una parte. Leggere l’articolo ad alta voce ne avrebbe conservato le parole, lasciando però allo spettatore gran parte della ricostruzione che un lettore fa soffermandosi su un paragrafo.
Il video è quindi partito da un creative brief, con un titolo cercabile, un hook, l’ordine dell’argomentazione e una direzione per la thumbnail. La domanda «What Does a CDP Actually Do?» dava un punto d’ingresso chiaro verso una risposta più architetturale di una definizione.
Da quel brief sono nati uno script parlato e quattordici scene, ognuna con un compito: stabilire il problema della proprietà del dato, spiegare perché la categoria piaceva, mostrare la svolta del warehouse o distinguere la CDP dai livelli adiacenti. Questo ci ha costretto a decidere quali esempi meritavano tempo e quali restavano nell’articolo per chi voleva il dettaglio.
C’era anche un passaggio di aggiornamento dei fatti, perché un articolo scritto mesi prima poteva contenere un’acquisizione o una descrizione degli analisti da ricontrollare prima di diventare un video.
Lo storyboard collegava questo lavoro editoriale alla produzione: per ogni scena conteneva narrazione, durata prevista e azione visiva, così testo e immagine avevano un riferimento comune. Le durate stimate servivano a pianificare, ma i tempi reali li ha dati poi la narrazione generata, ed è diventato essenziale quando i diagrammi dovevano cambiare in punti precisi di una frase.
Perché Remotion era adatto a video di architettura
Per costruire il video abbiamo usato Remotion, che permette di descrivere le composizioni in React, vederne l’anteprima nel browser e fare il render in un file video. In questo progetto significava avere sotto forma di codice proprio le cose da controllare: le dimensioni di una card, il percorso di un connettore, il momento in cui compare un’etichetta e quanto a lungo resta visibile uno stato dell’architettura.
Per questo materiale era la scelta giusta, perché le immagini erano diagrammi con un significato preciso. Un profilo doveva stare dentro il confine giusto, un flusso doveva arrivare alla destinazione giusta e lo spostamento di una capability da un sistema all’altro doveva restare leggibile: requisiti che potevamo esprimere, ispezionare e correggere nella composizione.
Lo stesso codice ha portato nei video l’identità visiva del sito, con Outfit e Inter, superfici scure neutre e l’accento indaco. Viveva in un progetto separato accanto al sito Astro, così correggere un paragrafo non dipende mai dalla macchina che produce sette minuti di video. Una distinzione va tenuta precisa: Remotion si descrive come source-available con una licenza propria, mentre Chatterbox e Faster Whisper sono progetti open source con licenza MIT, il primo per generare la narrazione e il secondo per verificarla, ed è una differenza che mi aspetterei un vendor sapesse spiegare in un briefing.
Una narrazione con la mia voce
Volevo i video narrati con la mia voce e generati in locale. Abbiamo usato Chatterbox Nano di Resemble AI, il modello più piccolo della famiglia: solo inglese, circa 110 milioni di parametri, pensato per l’inferenza su CPU e quindi la scelta pratica per una macchina senza GPU NVIDIA.
Ho fornito una registrazione di circa venti secondi, ridotta a un riferimento di diciassette che il modello usa per condizionare il suo output sulla mia voce. Si trattava di un modello esistente con un campione di riferimento, non dell’addestramento di un nuovo modello vocale da zero, e la registrazione è rimasta privata. Il supporto a Nano è arrivato dopo l’ultima release pacchettizzata, la versione 0.1.7, per cui il progetto fissa il codice upstream a una revisione precisa, insieme alla sua licenza MIT.
La prima preview era riconoscibile, ma alcune parti dell’inglese erano difficili da capire. Il tentativo successivo usava un dizionario di pronuncia, blocchi di testo più corti e impostazioni di generazione più prudenti: nella preview la dizione era più chiara e a orecchio la preferivo, ma la generazione completa ha mostrato un altro problema. Nella maggior parte delle clip di scena mancavano delle frasi, e la durata complessiva arrivava a circa quattordici minuti contro un obiettivo di otto.
Quella versione era inutilizzabile, e mi ha mostrato che riconoscere la mia voce e preferirne l’articolazione non diceva nulla sul fatto che ogni frase dello script fosse sopravvissuta alla generazione.
Abbiamo aggiunto un controllo indipendente di trascrizione con Faster Whisper, usando in locale un piccolo modello inglese. Il controllo confrontava il parlato generato con la narrazione approvata, misurando quanto testo veniva recuperato e quanto la sequenza di parole coincideva, e ci permetteva di segnalare scena per scena le probabili omissioni prima di spendere tempo in un render.
Il profilo bilanciato che l’ha sostituito teneva il dizionario di pronuncia, ma tornava alle impostazioni di campionamento predefinite del modello e a blocchi più lunghi, fino a 280 caratteri. La preview approvata durava circa 37 secondi, il controllo di trascrizione ha recuperato 96 parole contro le 95 dello script con una similarità di sequenza di 0,96, e il 9 agosto l’ho approvata a orecchio. Il candidato completo ha poi dovuto superare soglie minime di parole recuperate e di similarità in ognuna delle quattordici scene, e ci è riuscito, con circa sei minuti e cinquantuno secondi di narrazione e una timeline di poco più di sette minuti.
Abbiamo tenuto separato quel candidato finché non ha superato i controlli, così un nuovo tentativo non poteva mai sostituire in silenzio l’audio collegato allo storyboard, e solo allora l’abbiamo reso la narrazione attiva.
Anche il riconoscimento vocale sbaglia, e un punteggio di similarità non può stabilire se una voce suona come la mia o se è piacevole da ascoltare. A quelle domande rispondeva il mio ascolto, mentre il confronto con la trascrizione intercettava i guasti che una breve preview non aveva mostrato.
La generazione in locale ci ha dato il controllo sui file e un profilo vocale riutilizzabile, ma ha comunque consumato calcolo, attenzione e tempo di revisione, come ha dimostrato appunto il candidato scartato da quattordici minuti.
La scena del warehouse che ha cambiato la direzione visiva
Una volta sistemata la narrazione, il problema principale è diventato l’immagine. Il primo template sapeva mostrare etichette e animare card, ma i passaggi lunghi restavano statici, e aggiungere movimento metteva più attività sullo schermo senza aiutare granché chi cercava di capire cosa stessi dicendo.
La versione successiva usava i timestamp delle parole dell’audio approvato per allineare frasi brevi ed enfasi del diagramma: erano quei 95 momenti visivi, in media circa quattro secondi e mezzo ciascuno. Il ritmo era più studiato, ma troppi passaggi si affidavano ancora a movimenti simili nella stessa zona dello schermo, e l’animazione cambiava mentre la spiegazione restava povera.
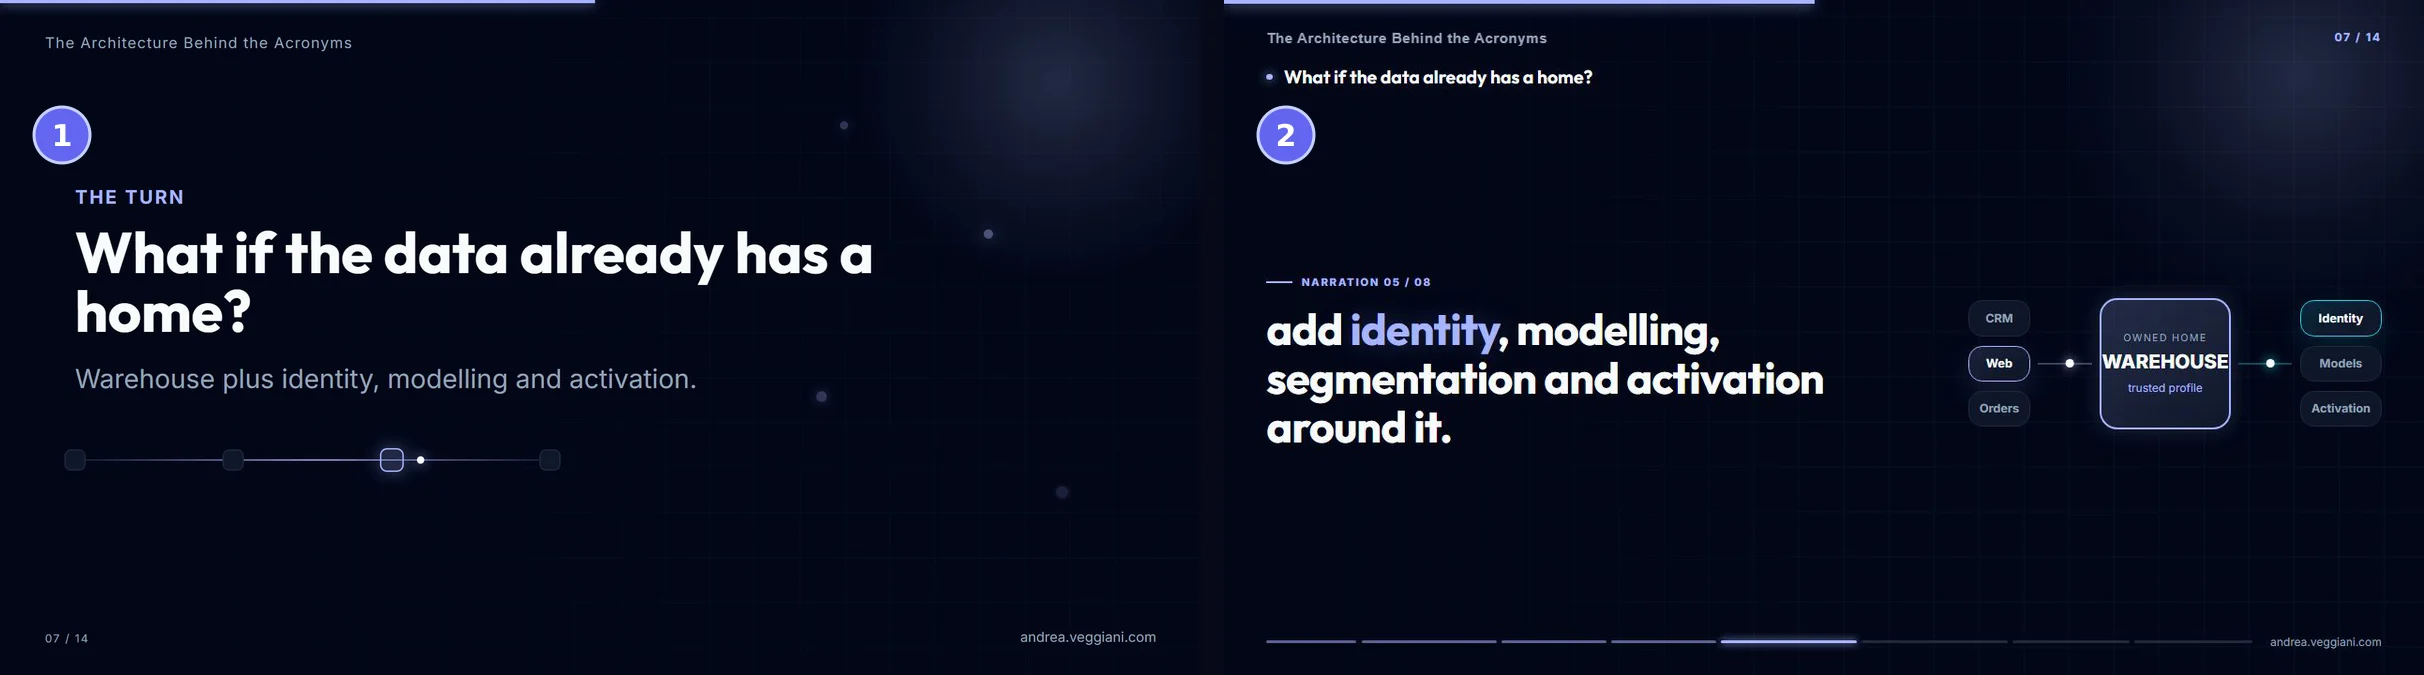
Figura 1. Lo stesso momento della scena del warehouse nelle due versioni scartate: il primo render completo (1) e la revisione da 95 momenti (2). La seconda si muove a tempo con la mia voce, eppure il diagramma spiega ancora molto poco.
La svolta è arrivata quando abbiamo ridotto il problema a una sola scena di 37 secondi, quella del warehouse, e ne abbiamo costruito la sequenza causale un’idea della narrazione alla volta, prima di toccare qualsiasi altra parte del video.
I dati di diverse fonti convergevano nel warehouse. Compariva una copia separata, di proprietà dell’applicazione, che rendeva visibile la duplicazione, e quella copia veniva respinta. Le capability si assemblavano attorno ai dati rimasti nel warehouse, il reverse ETL portava i profili verso gli strumenti operativi, il box unico della CDP veniva barrato e un livello di capability si posava sopra i dati aziendali. Alla fine lo spettatore poteva vedere perché le capability potessero sopravvivere anche quando il box unico non bastava più a descriverle.
Ogni movimento corrispondeva a un passaggio dell’argomentazione, e il diagramma che cambiava dava alla spiegazione parlata una conseguenza visibile, cioè proprio la qualità che mancava alle versioni precedenti.
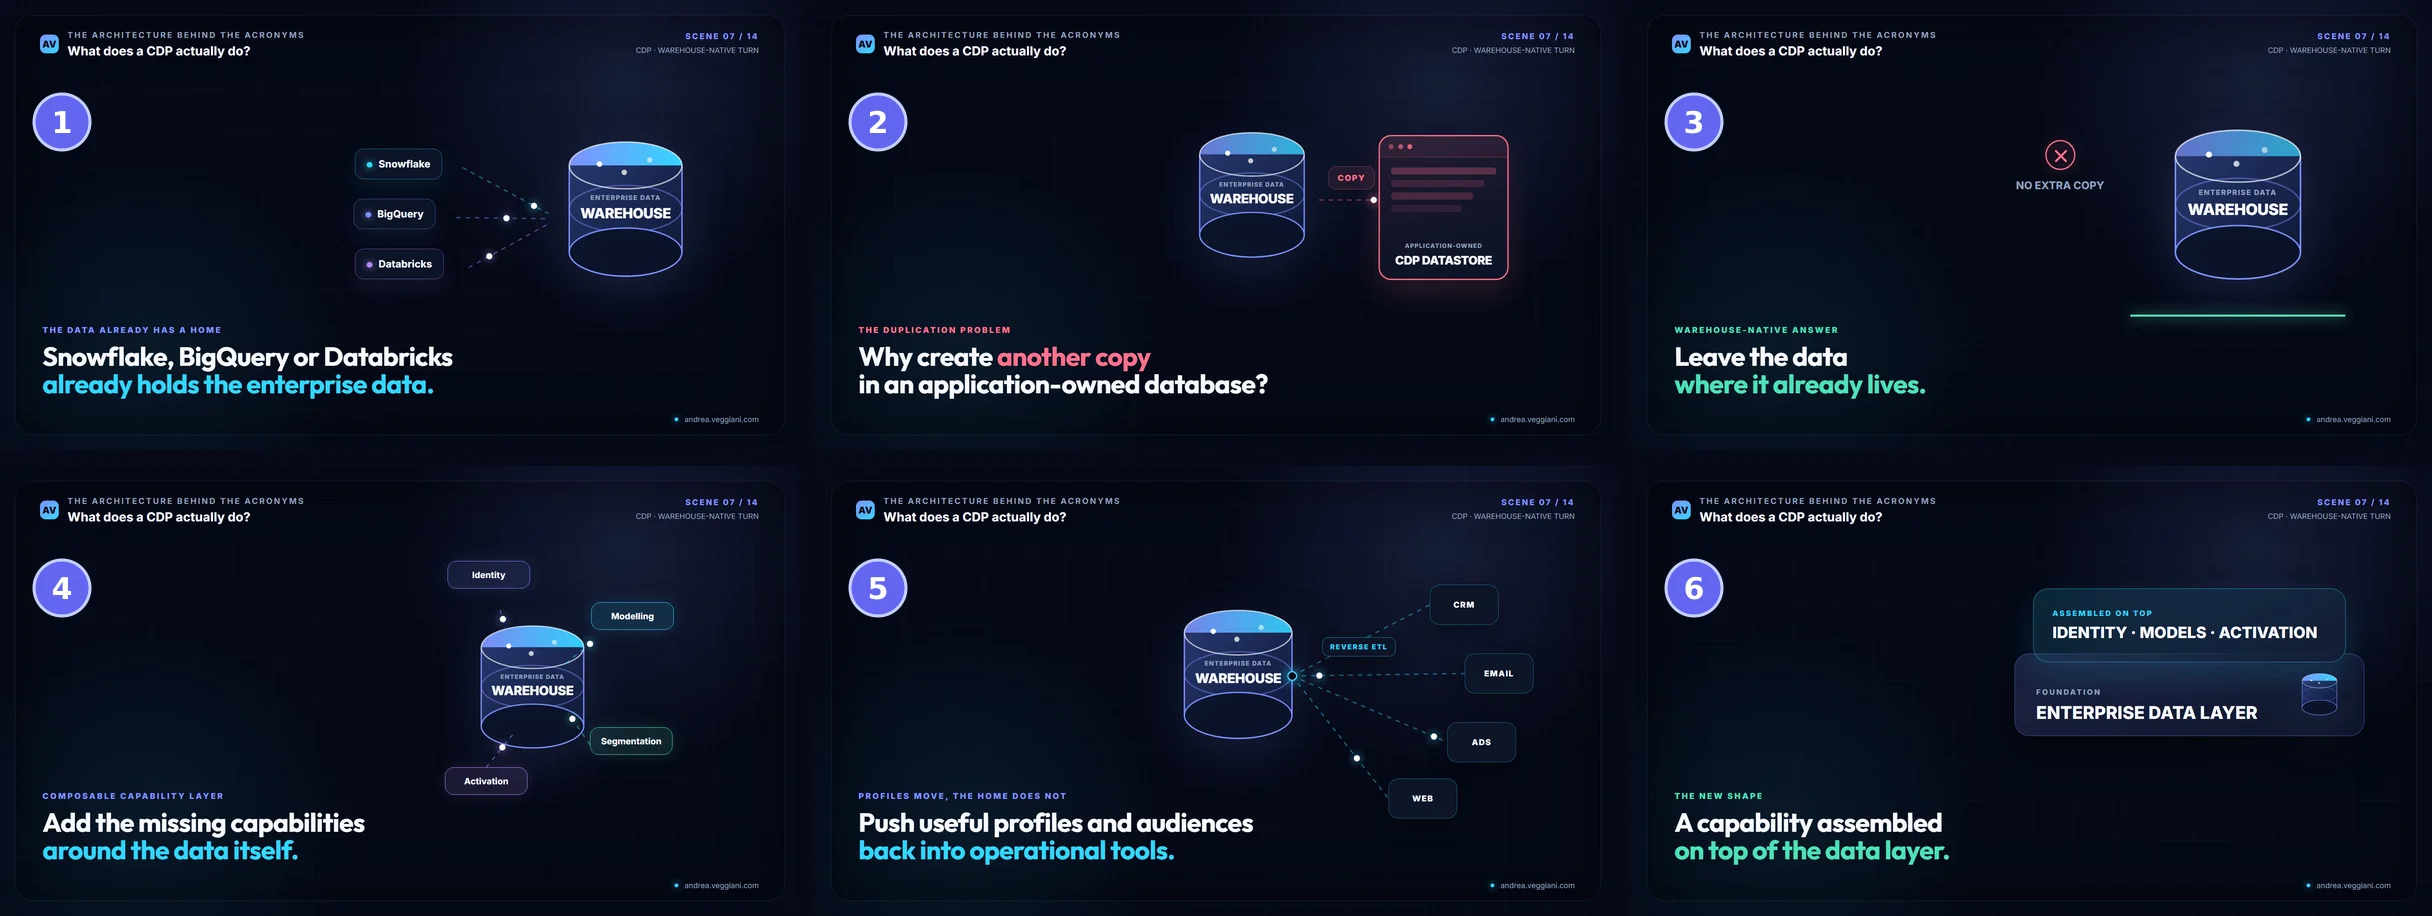
Figura 2. La scena del warehouse come è uscita nel video pubblico, in sei passaggi numerati. Ogni passaggio cambia l’architettura sullo schermo, ed è proprio il cambiamento che la narrazione sta descrivendo in quel momento.
Ho approvato quella direzione con una correzione: il testo dentro i simboli del diagramma doveva restare dentro. Il warehouse aveva bisogno di abbastanza spazio interno per etichette leggibili a scale diverse, ed è stata una piccola istruzione con conseguenze su tutta la produzione, perché lo stesso problema sarebbe tornato in card, contenitori e scene di confronto dense.
La prova ha mostrato anche quanto sia facile che un diagramma contraddica la propria narrazione. Una revisione successiva ha scoperto che il pannello etichettato come assemblato sopra veniva disegnato sotto le fondamenta, così per qualche secondo l’immagine sosteneva il contrario di quello che dicevo, e nulla nel render l’avrebbe segnalato.
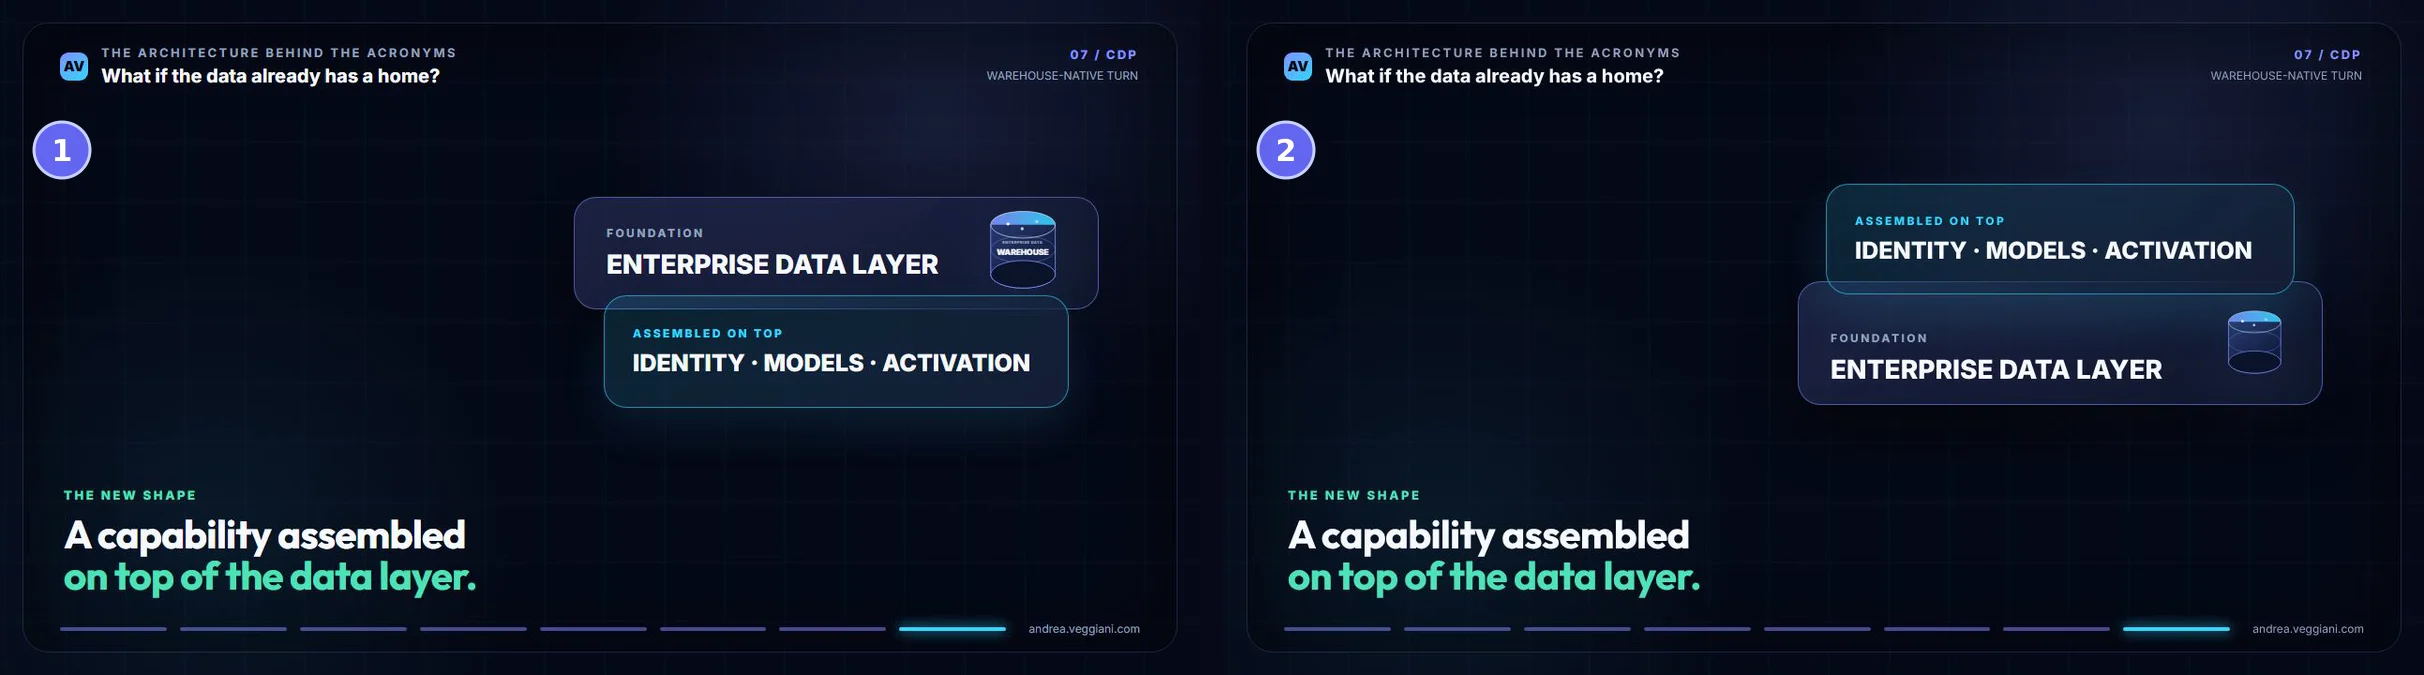
Figura 3. Il fotogramma finale della prova sul warehouse prima (1) e dopo (2) la revisione. Nel primo il pannello «assembled on top» sta sotto le fondamenta; nel secondo sta dove dice la narrazione.
La prova approvata è diventata il riferimento per il resto del video sulla CDP. Il film finito è pubblico su YouTube con lo stesso titolo dell’articolo sulla CDP, dura poco più di sette minuti e porta la narrazione approvata e questa direzione visiva; più avanti la produzione sulla DMP e un kit editoriale riutilizzabile ne hanno trasferito le lezioni in una struttura più coerente.
Figura 4. Il video finito sulla CDP su YouTube, in inglese, 7 minuti e 12 secondi compreso l’outro.
Cosa ha stabilito il primo pilota
Il risultato utile del pilota andava oltre il primo video: avevamo un modo per adattare un articolo in un’argomentazione parlata, un profilo vocale locale con un processo di revisione e una direzione visiva dimostrata da una scena che avevo guardato e approvato.
Avevamo anche un registro di ciò che non aveva funzionato. La voce più chiara poteva perdere contenuto, più momenti visivi potevano comunque produrre una spiegazione debole, e un diagramma accettabile a una dimensione poteva far scappare le etichette a un’altra. Ogni fallimento restringeva la richiesta successiva, perché potevamo indicare un file, un timestamp o un’etichetta precisi e dire esattamente cosa non andava.
Lo riconosco dal lavoro di architettura: il comportamento atteso deve diventare abbastanza esplicito perché qualcun altro possa implementarlo e contestarne il risultato. Qui voleva dire pronunciare una frase per intero e aiutare uno spettatore a seguire un profilo cliente mentre cambiava la sua collocazione architetturale.
Il primo render scartato aveva dimostrato che tutte le parti potevano produrre insieme un file, e la prova sul warehouse ci ha mostrato cosa valeva la pena produrre. La factory ha iniziato a diventare ripetibile quando un esempio approvato ha saputo dire più di un altro lungo prompt.
Il secondo articolo racconterà come il lavoro si è diviso tra me e due collaboratori AI e come ciascuno ha verificato l’altro; il terzo, come un pilota è diventato una routine di produzione e di pubblicazione. Usciranno entrambi nelle prossime settimane.
Fonti
Composizione video
- Remotion, Documentation. Riferimento per le composizioni video in React e il render.
- Remotion, License FAQ. Chiarisce la differenza tra software source-available e open source.
Generazione e verifica della voce
- Resemble AI, Chatterbox. La famiglia di modelli vocali con licenza MIT usata dalla factory, compreso il modello Nano pensato per la CPU.
- PyPI, chatterbox-tts release history. L’ultima release pacchettizzata, la 0.1.7, precede il supporto a Nano.
- SYSTRAN, Faster Whisper. L’implementazione di trascrizione usata per i controlli sulla narrazione e per i tempi.