Questo articolo è una traduzione assistita dall’AI dell’originale in inglese, revisionata dall’autore.
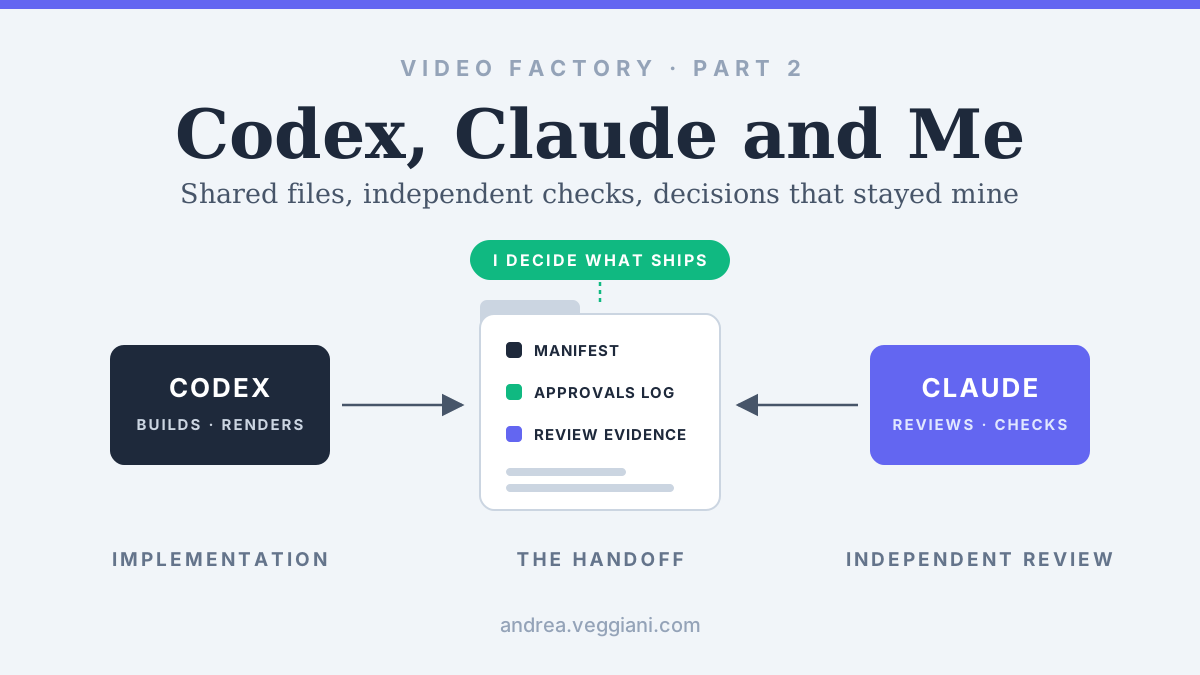
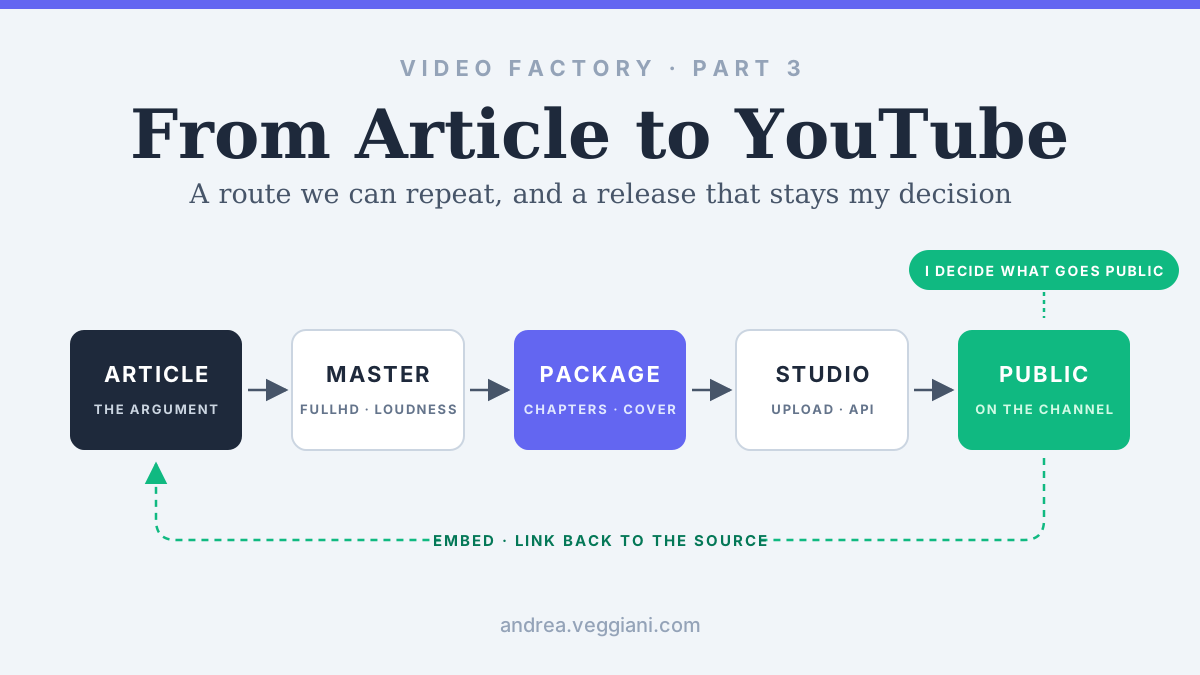
Terzo di tre articoli sulla costruzione della mia video factory. Il primo racconta il pilota sulla CDP, il secondo la collaborazione tra Codex, Claude Cowork e me. Questo segue la produzione fino a YouTube e ritorno al sito.
Il 3 settembre la factory aveva tre master FullHD con visual e narrazione approvati. L’audit di lancio trovava comunque del lavoro da fare: l’audio andava portato a un livello di ascolto più adatto, e nei job mancava un set completo di descrizioni, thumbnail, sottotitoli e capitoli. Nei registri di produzione non c’era nessun ID video caricato, quindi i file esistevano ma uno spettatore non poteva ancora trovarli, capire perché guardarli o risalire da lì all’argomentazione originale.
Un processo video ripetibile deve coprire l’intero percorso da un articolo a qualcosa che un lettore può scoprire e guardare. In questo progetto quel percorso oggi unisce produzione e packaging automatizzati a decisioni di revisione e passaggi in YouTube Studio.
Un render finito non era ancora una pubblicazione
L’audit di lancio ha reso visibile il lavoro rimanente guardando i video come un insieme. La CDP impostava la questione del profilo affidabile, il DMP raccontava una categoria il cui lavoro si era spostato altrove e la CEP portava l’argomento sull’engagement e sul decisioning. Script e linguaggio visivo stavano insieme, e le durate tra i sette e gli otto minuti formavano un primo gruppo coerente.
Anche il suono era coerente, ma con un livello integrato di circa meno 24 LUFS era più basso di quanto volessi per il lancio. I LUFS misurano la loudness percepita nel tempo, e un file può non avere clipping e sembrare comunque troppo basso. Abbiamo scelto un trattamento con obiettivo di circa meno 16 LUFS come nostro standard di produzione, poi abbiamo controllato e rivisto l’audio risultante.
Le altre mancanze erano editoriali. Il titolo di un video doveva funzionare fuori dal contesto del mio sito, la descrizione doveva introdurre l’argomento e rendere facile raggiungere l’articolo, e la thumbnail doveva comunicare alla dimensione in cui la si incontra scorrendo. Questi asset dovevano entrare nel job, altrimenti ogni caricamento avrebbe aperto un altro giro di assemblaggio da appunti sparsi.
Le fasi di produzione che potevamo ripetere
Abbiamo raccolto il workflow in una skill riusabile, produce-article-video: istruzioni e strumenti di supporto che un collaboratore può seguire per un job nuovo o ripreso. Si parte da un articolo e da un creative brief con titolo, hook, narrazione e direzione visiva. La mia approvazione sblocca script e storyboard, e la loro approvazione sblocca il lavoro sulla voce.
La narrazione usava il setup locale Chatterbox Nano e il profilo bilanciato definito durante il pilota sulla CDP. Una breve anteprima da ascoltare precedeva la generazione completa, le clip delle scene venivano controllate per eventuali omissioni e lo storyboard veniva ritarato sulla loro durata reale, così che il timing derivato dal parlato aiutasse i diagrammi a seguire la spiegazione.
L’implementazione visiva partiva dal kit editoriale riusabile, con il lavoro specifico di ogni scena costruito attorno. Palette, tipografia, aree di layout e helper di animazione si potevano riusare, senza fingere che la stessa animazione spiegasse ogni concetto architetturale: lo strato che scompare nel DMP e i confini di ownership in competizione nella CEP avevano comunque bisogno di un trattamento visivo proprio.
Dopo i controlli meno costosi arrivavano un video di revisione, poi il master FullHD autorizzato e l’ispezione del file codificato. Seguivano la finitura del suono e il pacchetto di pubblicazione, con stato e file registrati perché un’altra sessione potesse riprendere il lavoro.
Il workflow distingueva uno script in attesa di approvazione da un render in attesa di revisione visiva o da un master completo in attesa di pubblicazione, e riavviare una sessione non richiedeva di rigenerare ciò che già funzionava.
È una versione concreta del problema di gestione dello stato di cui ho scritto in Agenti in produzione: l’azione successiva dipende da ciò che è già successo e da ciò che è ancora valido, non semplicemente dall’esistenza di un file con un nome promettente.
Controlli di qualità che costano meno di un altro render completo
Un’etichetta che esce dal suo riquadro si vede in un fermo immagine, e una transizione confusa si può ispezionare nel punto in cui cambiano gli stati. Le prime produzioni ci hanno insegnato a usare questi controlli prima di generare un altro master da sette minuti.
Abbiamo quindi anticipato i controlli. I controlli statici potevano intercettare pattern di transizione noti, e il testo si poteva misurare dopo il caricamento dei font reali, perché far stare un’etichetta in un riquadro dipende dai glifi renderizzati e dallo spazio disponibile. I fotogrammi rappresentativi si potevano ispezionare prima di un proxy di revisione, e il proxy si poteva giudicare prima del render finale, più costoso.
Il kit ha anche guadagnato un controllo sui claim principali che superano il numero di righe consentito. Un titolo che si allunga di una riga può schiacciare il diagramma sottostante, e rendere esplicita la regola ha permesso alla factory di verificarla prima che fossi io ad accorgermi della conseguenza.
L’ispezione del file finale restava necessaria. Controllavamo dimensioni, numero di fotogrammi, proprietà audio e la decodifica completa del file, e confrontavamo fotogrammi codificati selezionati con i render di origine. Gli smoke check del renderer producevano due volte gli stessi fotogrammi campione, per verificare che il setup fosse coerente prima del master.
FFmpeg e il suo strumento di ispezione, ffprobe, facevano gran parte del lavoro sui media attorno alle composizioni Remotion: esaminare gli stream, estrarre fotogrammi, elaborare l’audio e assemblare i file di consegna. Quando una modifica riguardava solo il suono, lo stream video approvato si poteva copiare senza ricodificare l’immagine, e quando una correzione successiva dell’immagine riusava il suono approvato verificavamo che l’audio restasse invariato.
Niente di tutto questo eliminava il bisogno di guardare la spiegazione. Riduceva però la revisione umana spesa a scoprire problemi meccanici che il workflow poteva individuare prima, e dava a ogni correzione un perimetro chiaro da verificare in seguito.
Preparare il video per YouTube
Il passaggio sull’audio usava la normalizzazione della loudness in due passate con il filtro loudnorm di FFmpeg. I master risultanti misuravano tra circa meno 16,1 e meno 16,2 LUFS, senza campioni in clipping nei controlli, e i loro stream video approvati restavano identici alle versioni precedenti. Approvato all’ascolto, quel suono andava poi conservato in tutte le finiture successive.
Anche gli ultimi secondi richiedevano attenzione. I master originali finivano poco dopo le ultime parole, lasciando poco spazio per un invito al passo successivo. Alla fine abbiamo aggiunto un outro di dieci secondi con un’operazione di finitura separata che conservava gli stream approvati, dando una coda alla consegna senza far passare ogni scena da un altro render completo. Gli elementi cliccabili della schermata finale restavano un compito di Studio.
I sottotitoli erano un problema diverso, perché il testo l’avevamo già nello script approvato e non c’era motivo di lasciare a una nuova trascrizione la decisione su cosa intendessi dire. La difficoltà stava nel collocare quelle parole nell’audio con abbastanza precisione da ottenere sottotitoli leggibili.
I primi pacchetti di sottotitoli usavano timing stimati. Poi abbiamo usato i timestamp per parola di Faster Whisper, mappato la narrazione approvata su quegli ancoraggi e interpolato i passaggi senza corrispondenza dentro i confini delle scene, e i report di ritaratura confermavano che il testo restava invariato. Nel video sulla CEP diciotto cue si sono spostati di più di un secondo, e la revisione in riproduzione restava comunque utile, soprattutto dove l’allineamento si basava sull’interpolazione.
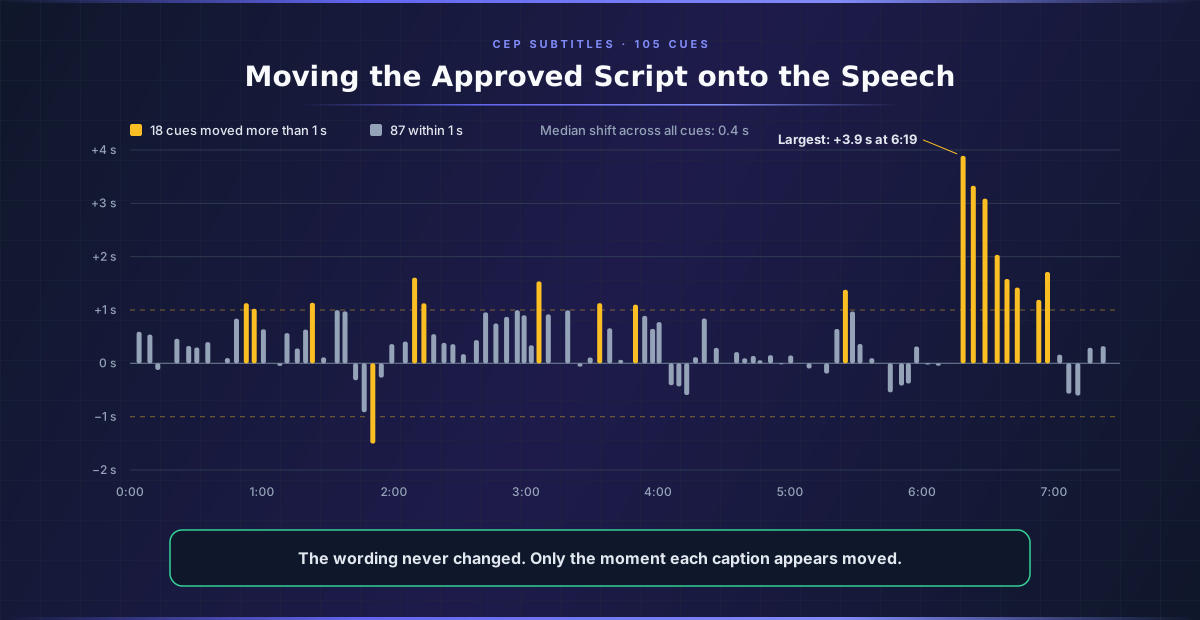
Figura 1. Di quanto si è spostato ogni sottotitolo del video sulla CEP allineando lo script approvato ai timestamp per parola di Faster Whisper, dal report di ritaratura salvato.
La revisione delle thumbnail usava un contact sheet con ogni immagine mostrata a 320 per 180 pixel, un test del titolo e del diagramma più utile che guardare solo l’immagine a piena dimensione. I capitoli venivano dalla timeline reale, raggruppati diversamente dove un confine di scena era troppo breve per funzionare da sezione autonoma.
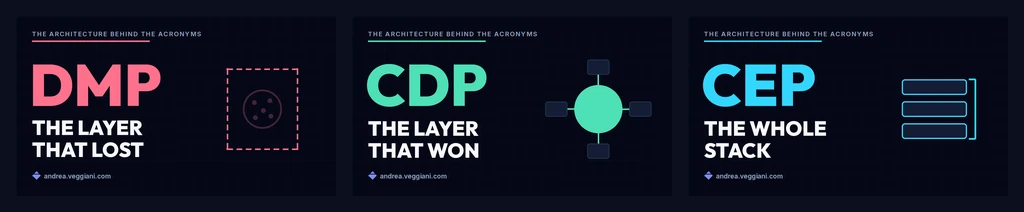
Figura 2. Il contact sheet dell’8 settembre usato per valutare le prime tre thumbnail alla dimensione reale, prima del caricamento.
Anche le descrizioni hanno richiesto iterazioni dopo il caricamento. La prima versione metteva l’URL dell’articolo sulla prima riga, che nella descrizione compressa sprecava lo spazio più prezioso per un indirizzo troncato. Le descrizioni riviste di DMP e CEP aprivano con un hook, tenevano il link all’articolo vicino all’inizio e aggiungevano percorsi pertinenti verso il sito. Il controllo nel codice è cambiato con quella decisione: ora richiede il link canonico all’articolo nelle prime righe, senza pretendere che sia la prima cosa che legge lo spettatore.
Dove YouTube Studio e l’API si dividono il lavoro
Il file video lo carichiamo da YouTube Studio, poi lo script di pubblicazione della factory prende l’ID esistente e applica titolo, descrizione, thumbnail, sottotitoli in inglese e appartenenza alla playlist della serie tramite la YouTube Data API, lasciando invariata la visibilità del video.
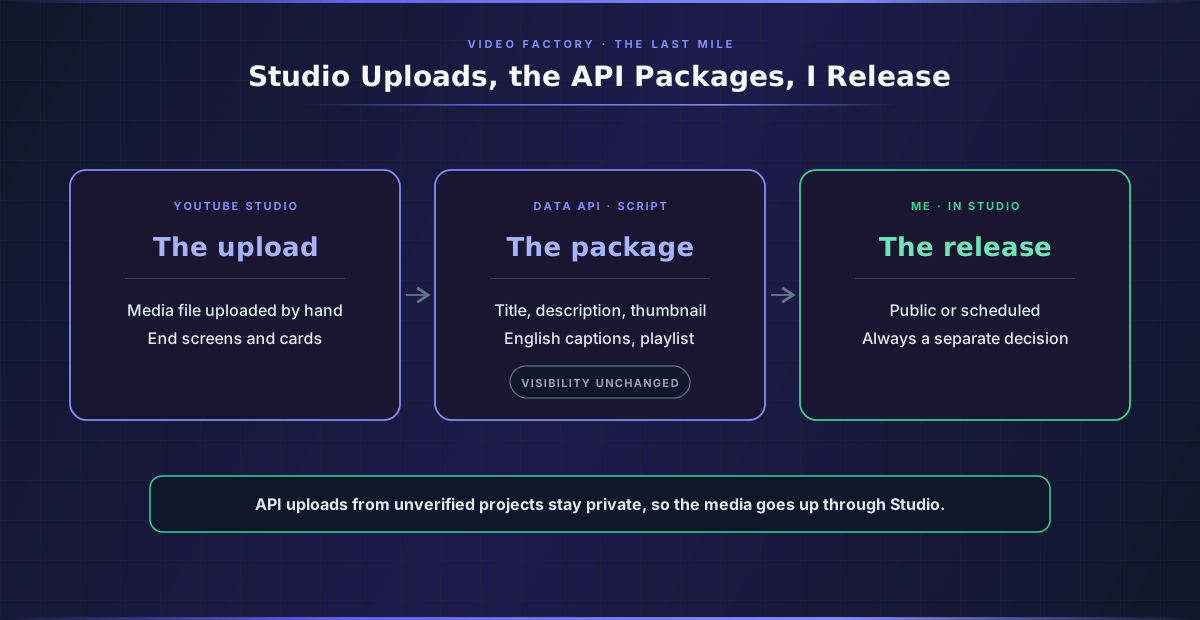
Figura 3. Chi fa cosa tra un master approvato e un video pubblico.
La documentazione di YouTube sul caricamento dice che i video caricati da progetti API non verificati creati dopo il 28 luglio 2020 restano limitati alla visualizzazione privata finché il progetto non supera un audit. Abbiamo quindi usato Studio per caricare il file e l’API per il lavoro ripetibile attorno a un video già esistente.
Il pacchetto di pubblicazione esiste così prima di essere applicato: si può rivedere in locale, controllare che non manchi nulla e applicare quando il video caricato ha un ID. Lo script cerca una traccia di sottotitoli in inglese già presente per aggiornarla e verifica se il video è già nella playlist prima di aggiungerlo, così un secondo passaggio non crea duplicati.
Il 9 settembre le descrizioni riviste sono state applicate ai video privati su DMP e CEP. Una lettura separata dei dati della piattaforma ha confermato che le descrizioni corrispondevano ai file locali e che entrambi i video erano rimasti privati.
La mia decisione di rendere pubblico un video o di programmarlo resta separata, così come il lavoro in Studio sulle schermate finali, ed è questo il confine operativo a cui siamo arrivati. Chiamarla una pubblicazione completamente automatica dall’articolo a YouTube descriverebbe un sistema diverso da quello che abbiamo costruito.
Riportare il video all’articolo
L’articolo di partenza resta il luogo in cui vivono l’argomentazione completa, i riferimenti e i collegamenti con gli altri pezzi. Il video offre a quell’argomentazione un altro ingresso, quindi il rapporto deve funzionare in entrambe le direzioni.
Le descrizioni rimandano all’articolo pertinente e propongono letture adatte all’episodio. Il sito può incorporare il video tramite un ID YouTube associato all’articolo, e così la spiegazione sulla CDP si può leggere e guardare dalla stessa pagina.
Abbiamo anche aggiunto link al canale in tutto il sito e dati strutturati specifici per il video nel template degli articoli. I dettagli richiedevano attenzione, perché un articolo scritto a giugno non deve far pensare che il suo video di settembre sia stato caricato a giugno. Abbiamo aggiunto date e durate esplicite del video e usato la sua thumbnail al posto della copertina dell’articolo per descriverlo. La lingua della narrazione resta l’inglese anche quando l’embed compare sulla pagina dell’articolo in italiano.
Questi campi seguono la documentazione di Google su VideoObject. Descrivono il materiale con precisione, senza dimostrare che la visibilità nella ricerca sia migliorata, e ora il video e il suo testo di partenza contengono abbastanza informazioni per riconoscersi a vicenda.
Cosa funziona e cosa resta una scelta deliberata
Il video sulla CDP è diventato pubblico su YouTube l’8 settembre 2026, e nella prima settimana di ottobre lo stesso percorso aveva portato alla pubblicazione gli episodi su DMP, CEP, CMS, DXP, CRM e DAM e i primi tre recap del MarTech Watch, ognuno con una decisione separata presa da me in Studio. L’episodio sul MAP e il Watch della settimana 41 sono stati caricati come privati il 10 ottobre con i loro pacchetti applicati, e li ho resi pubblici l’11 e il 12 ottobre, per un totale di dodici video pubblici.
Il prossimo video sugli acronimi può partire da un profilo vocale noto, un kit editoriale, un workflow salvato e controlli nati da produzioni reali, e avrà comunque bisogno di uno script adattato, di una spiegazione costruita per le sue scene e di una revisione. Il processo è diventato ripetibile senza rendere intercambiabile il lavoro editoriale.
Non ho ancora una serie di episodi pubblici abbastanza lunga per parlare di risultati di pubblico o di un tempo medio di produzione affidabile. Ho invece un percorso completo da un articolo esistente a un video pubblico, e i componenti per ripeterlo riscoprendo meno decisioni lungo la strada.
L’audit del 3 settembre è stato utile proprio perché guardava oltre il render finito, e ha costretto la factory a includere ciò che rende un video utilizzabile come pubblicazione: un suono coerente, sottotitoli leggibili, un motivo per cliccare e una strada per tornare alla fonte. L’automazione utile è il lavoro che ora possiamo ripetere, tenendo per noi la responsabilità della spiegazione e della sua pubblicazione.
Tutti gli episodi finiti sono sul mio canale YouTube.
Fonti
Contesto già pubblicato
- Andrea Veggiani, Dal blog al video: costruire la mia video factory. Il primo dei tre articoli, sul pilota della CDP, il workflow della voce e la direzione visiva.
- Andrea Veggiani, Costruire una video factory con Codex e Claude Cowork. Il secondo, sui passaggi di consegne, la revisione indipendente e i controlli lasciati da ogni correzione.
- Andrea Veggiani, Agenti in produzione: quello che le demo lasciano fuori. Le pratiche di gestione dello stato applicate al workflow di produzione.
Elaborazione dei media
- FFmpeg, Loudnorm filter. Documenta la normalizzazione della loudness usata nella finitura audio.
- SYSTRAN, Faster Whisper. L’implementazione di trascrizione usata per ricavare gli ancoraggi di timing.
Pubblicazione su YouTube
- Google, Videos: insert. Documenta la limitazione sui caricamenti da progetti API non verificati.
- Google, Captions: insert. Riferimento per caricare una traccia di sottotitoli su un video esistente.
- Google, Thumbnails: set. Riferimento per applicare thumbnail personalizzate.
- Google, PlaylistItems: insert. Riferimento per aggiungere un video a una playlist.
Integrazione con il sito
- Google Search Central, Video structured data. Riferimento per descrivere un video associato nella pagina dell’articolo.